2021年3月1日星期一

85m²小套三学区房,可盐可甜超多收纳!

前言

小可爱是17年下的房子,装完也很久了,男生小可爱一直在出差,也不着急住,今年年底我的催促下,我们一起拍摄了照片。 我最近被问到对家、对温度是怎么的理解。 我从来不觉得家要多么大的豪宅或者说家要多少豪华的装修。我觉得家是和爱的人在一起。不是装修赋予了家的温度,是家里的人,是一个人在闹一个人在笑,一个人在打孩子,另外一个还帮忙说教。 家是烟火的味道,是生活的味道,是一家人在一起爱的温度。 每一次聊到对家的期望是什么样,我总是能在女生的眼里看到星光,对家的憧憬,对美好未来的希望,在男生眼里看到的是女生的脸庞。 我作为一个来帮他们实现期望的人,我也是充满温暖和幸福的。


空间展示 玄关

入户门自购毛毡改造,消灭大红门。鞋柜的下面位置我们留了一部分放拖鞋,下面柜子放鞋子,中间留空放包包,上面做收纳。挂衣服的话这个柜子的另外一部分是用来挂衣服的。
客厅

硬装的搭配依次是地深墙中顶白,由于房子本身面积不大,收纳就更加重要了,所以电视墙是以柜子做造型,兼顾装饰和储物的。

这个墙漆的颜色真是深得我心

以前总是把电视墙做这个造型那个造型,我一直都觉得浪费,有什么造型是可以保证审美一直在变的情况下一直看不腻的嘛?我觉得基本没有。但是好像都觉得电视墙是需要做造型的,这个观念一时半会也很难去彻底改变,所以我更喜欢做成柜子,做造型也是花钱,那不如做柜子,钱也花了,装饰也做了,但是还能放东西。这个就是我做柜子的初衷。

沙发选择的是很舒适的布艺沙发

因为空间比较小,所以在家具的选择上,我大部分是选择了轻盈一些的家具,能让空间显得稍微大一些。

沙发墙挂画打破传统居中挂法,更加灵活多变。小块的地毯装饰效果也是很好的。

客厅一角

冬天的阳光
餐厅

客厅到餐厅一览

为了节省空间做的是卡座的设计

原厨房和书房墙砸掉重建之后,让餐厅的空间更大一些。

这样看,餐厅的面积还是可以的
走廊

这边是餐厅到房间的过道
厨房

左侧高柜增加储物。

吊柜做白色能显得空间大一些,不至于压抑。
卧室

儿童房不是很大,做榻榻米是最好的选择。

休息-储物-学习,一应俱全。

衣柜做在床头两侧,这样床两边的活动空间能更大。
书房

书房储物办公兼顾。

做了壁柜床,家里来人留宿也不是问题。
阳台

宝贝们的日光浴。
卫生间

小户型镜柜必不可少,不然台面会乱

原文转载:http://home.shaoqun.com/a/106197.html

跨境电商:https://www.ikjzd.com/

net-a-porter:https://www.ikjzd.com/w/2132

出口易:https://www.ikjzd.com/w/1317


前言 小可爱是17年下的房子,装完也很久了,男生小可爱一直在出差,也不着急住,今年年底我的催促下,我们一起拍摄了照片。我最近被问到对家、对温度是怎么的理解。我从来不觉得家要多么大的豪宅或者说家要多少豪华的装修。我觉得家是和爱的人在一起。不是装修赋予了家的温度,是家里的人,是一个人在闹一个人在笑,一个人在打孩子,另外一个还帮忙说教。家是烟火的味道,是生活的味道,是一家人在一起爱的温度
焦点科技:https://www.ikjzd.com/w/1831
易佰:https://www.ikjzd.com/w/2023
深兰科技:https://www.ikjzd.com/w/1517
海外仓的安全如何保证?这些你需要知道……:https://www.ikjzd.com/home/97489
Shopee店铺评分:https://www.ikjzd.com/w/2679
2019年亚马逊将的运营方向有这六大举措!:https://www.ikjzd.com/home/15545

“反亚马逊联盟”壮大:千亿GMV打头,Shopify们正在全球各地崛起

2020年,全球电商的涨势让Shopify这个帮助商家在线开店的企业成了新贵。

财报显示,2020年,Shopify总收入为29.295亿美元,比2019年增长86%;GMV为1196亿美元,比2019年增长96%;毛利润增长78%,达到15.415亿美元;调整后的毛利润增长78%,达到15.69亿美元。

当人们谈论着Shopify的"人人商店"如何撼动亚马逊的"万货商店"时,一个同派系的"内战"也已开启——尚未坐稳独立站SaaS服务商第一宝座的Shopify,正迎来各方势力的"围攻"。

Shopify的全球竞争对手

BigCommerce被业内人士认为是最有希望冲击Shopify的一个竞争对手。这个成立于2009年的SaaS平台,在2020年迎来大涨并顺利上市。2020年,BigCommerce全年总收入为1.812亿美元,同比增长41%。

对于Shopify来说,BigCommerce的竞争主要来自对大型企业客户的争夺,Woolrich、Avery Dennison、Ben & Jerry's等美国老牌本土企业以及索尼这样的大型跨境公司,都选择了BigCommerce。

除了BigCommerce,Shopify还面临着Wix、Squarespace、Square Online、Weebly等企业在不同维度的竞争。据统计,目前市场上的建站SaaS工具超过了400家。

Wix主要针对小型企业,Squarespace偏向优质店面设计,Square Online提供完整的免费版吸引顾客,Weebly针对小型实体店推出网上下单、线下取货服务……这些独具特色又颇有针对性的服务,在不同领域瓜分着Shopify的潜在市场。

除此之外,科技巨头在电商领域的拓展同样让Shopify头疼——Adobe在2018年收购了独立站建站技术公司Magento,微软在2019年推出了Dynamics 365。

而在区域市场,本土独立站SaaS服务商利用对本土商家和文化的理解,打造了诸多更贴近本国客户使用习惯和需求的产品,与Shopify形成了一定的竞争关系。

在日本市场,Shopify的主要竞争对手是Base。Base成立于2012年,与Shopify相比还很年轻,公司体量不大,但2020年,Base总GMV和销售量迎来爆发,分别同比增长133%和177%。目前Base估值已超过17亿美元,是2020年3月估值(2亿美元)的8倍多。更让本土公司心动的是,除信用卡附加费外,Base的服务完全免费,而仅使用Shopify基础版每月就要花费29美元。

在阿拉伯地区,成立于2016年的电子商务公司Salla是Shopify的主要竞争对手,Salla的竞争优势在于本土化的语言服务,能够帮助中小企业建立自己的阿拉伯语线上商店。目前Salla公司已经为1多万家在线商店处理了超过800万笔订单,商品总价值超过了20亿里亚尔(约合5.33亿美元)。

在中国市场,Shopify同样面临着本土独立站SaaS服务商的竞争,并且,他们的网站设计、后台操作更符合中国商家的使用习惯,售后服务大多为中国客服,且减少了海内外时间差。除了这些优势,部分中国本土独立站SaaS服务商还以免佣金为卖点,吸引商家入驻。

比如,店匠Shoplazza,去年10月获得了红杉资本领投的千万级美元资金;Ueeshop,已成立13年,据其公布数据,已有超过23500卖家使用Ueeshop;Shopline创始于2013年,全球突破20万卖家,触及3.5亿消费者;XShoppy上平台卖家数已超过2万家,预计2020年平台全年成交将突破100亿元;中国首个市值超百亿美元的SaaS服务商有赞,也在2020年发布了海外版AllValue。此外,还有FunPinPin、Shoptago、Shoppy等一众新生力量。

谁在滋养Shopify们?

全球市场高度分散的流量给独立站的生存提供了肥沃的土壤。

在国内,消费者更习惯在电商平台购物而非打开某一品牌的官网,阿里、京东、拼多多在中国电商市场占有率总计达到70%以上。

而国外恰恰是相反的。在美国,亚马逊、eBay等巨头总共所占的电商市场份额不到50%,消费者更青睐具备特色的中小型品牌电商独立站,也习惯于通过邮件、搜索引擎、社交网站等途径获取商品信息。有报告称,25%的美国消费者更倾向于从DTC品牌独立站购买商品,而且,在品牌独立站购买商品的数量占据他们购买商品总量的三分之一。

这让一众中国跨境电商出口卖家看到了希望——除了涌入亚马逊、eBay等平台,独立站或许是更有想象空间的选择。

"我做独立站,一部分原因是亚马逊上利润薄,Listing不靠前更是卖不出去东西,还有一部分原因是我的朋友做独立站确实效果不错,我也想试试看。"一位从去年开始做独立站的跨境卖家向亿邦动力表示,亚马逊平台的竞争变得越来越激烈,流量成本也水涨船高,且卖家常常会面临平台政策收紧带来的问题。

另一方面,Shopify拿出的数据也没有让对独立站给予厚望的卖家们失望。2020年Shopify黑五网一战报显示,Shopify独立站卖家们的总销售额超过了51亿美元,销量比往年增加了76%,超过了亚马逊第三方卖家的销量。

然而,根据Statista的数据,在美国电商SaaS服务商市场,Shopify也仅占据了约30%的份额,BigCommerce、Squarespace、Wix等市场主要参与者,约各占美国电商SaaS服务商市场的10%。也就是说,还有大量市场机会留给了其他独立站SaaS服务商。

更重要的是,在区域市场,如中国,Shopify面临着"更懂客户需求"的本土强敌的冲击。

"Shopify对中国卖家的态度总有种摇摆不定的感觉。"一位Shopify的中国合作伙伴直言,一方面,数量庞大的中国卖家群体早已成为全球电商市场的主力军,是一块难以割舍的"肥肉",另一方面,虽然一两年前Shopify就开始进入中国市场了,但一直没有太大的动作,甚至一度连中国办公室都没有。

此外,由于出现过一些不守规矩的卖家,也让Shopify对中国卖家群体的吸收表现得很迟疑。"2020年,Shopify'封杀'了一批站群卖家,比如,年初的时候广东某女装独立站大卖家就被封了200多个账号。"某独立站卖家向亿邦动力指出,"虽然不合规的卖家仅是少数,但

外国公司在治理措施上是不够柔性的,会明显对中国卖家更严,这也导致很多人不敢用Shopify了。"

"这个缝隙的存在,让大批Shopify的潜客投向了更容易沟通、更理解中国卖家真实需求的本土服务商的怀抱。"该卖家谈道。

据悉,除了沟通更方便之外,国内的类Shopify服务商们也凭借免佣服务、更低使用门槛、本土化运营等优势"收割"了大批中国卖家。比如,店匠Shoplazza在2020年上半年短短几个月便增加了上万客户。

店匠Shoplazza相关负责人向亿邦动力表示,与Shopify相比,中国本土服务商最大的优势在于,产品更贴近国内客户的使用习惯和需求。"另外客户在和本土服务商沟通时,也不需要考虑时差的问题,对于客户来说,客服响应时间也很重要。"其指出。

"反亚马逊联盟"日益壮大

一个大背景是,跨境电商已然进入一个新的发展阶段——品牌独立站成为了越来越多卖家关注的方向。

一位SaaS服务商直言:"DTC品牌独立站拥有更高的溢价能力。而在亚马逊等平台,广告费用、获客成本的上涨,使得卖家的生存空间被压缩。卖家们赚着微薄的利润,还无法建立自有流量池、掌握用户数据,这些因素都促使'反亚马逊联盟'日益壮大。"

而"叛军"的壮大,也吸引了更多的"军火商"——Shopify们,并带动一系列相关服务的高速发展。网经社数据显示,2020年中国跨境电商领域共有33家企业获得融资,融资总额超70.9亿人民币。其中,包括支付服务商、物流服务商、ERP服务商等在内的跨境电商服务商超过15家。

一位跨境卖家表示:"相比于前几年那些需要自建站、自己找流量拉支付的独立站来说,我们太幸运了,现在的SaaS建站可以说是'傻瓜式'的,谁都能做。同时,流量平台越来越丰富、多元,物流、支付服务可选项也很多。"

新的市场窗口正在打开,新的思维方式正在上演。谁能成为下一个SHEIN,成了业内最热门的话题之一。

不可否认的是,当千万个类SHEIN的独立站崛起,他们一定会蚕食掉部分传统电商平台的市场份额。但对于大部分转移到独立站的卖家来说,看到希望的另一面也是残酷竞争的开始。当这一模式的门槛越来越低、玩家越来越多,大浪淘沙,最后留下的只会是更为优质的服务商和卖家。 

(来源:亿邦动力)

文章来源:https://www.ikjzd.com/home/142727

跨境电商:https://www.ikjzd.com/

盘古集团:https://www.ikjzd.com/w/1448

万色:https://www.ikjzd.com/w/2382

美菜网:https://www.ikjzd.com/w/1874

"反亚马逊联盟"壮大:千亿GMV打头,Shopify们正在全球各地崛起

当人们谈论着Shopify的"人人商店"如何撼动亚马逊的"万货商店"时,一个同派系的"内战"也已开启……

俄罗斯“男人节”电商促销,男性用品销量平均上涨2倍

俄罗斯"男人节"由来


"男人节"是从俄罗斯的祖国保卫者日衍生出来的。1919年初,为纪念苏俄红军建立,苏俄中央执行委员会决定将2月23日定为节日。


1995年,俄罗斯国家杜马将这一节日命名为祖国保卫者日。2002年开始,每逢祖国保卫者日,俄罗斯全国放假一天。在这一天,俄罗斯会举行阅军等隆重仪式。


随着时间的流逝,祖国保卫者日逐渐被赋予另一种涵义。俄罗斯人将这一天当成"男人节",并在这一天为身边的男性赠送礼物。


剃须泡沫销量增长252%,男性用品热销


为了迎接节日的到来,俄罗斯人在2月23日到来前就开始着手准备礼物,俄罗斯各个电商也会举行"男人节"促销。


俄罗斯电商平台Wildberries表示,在"男人节"之前,袜子、剃须泡沫的销量翻了一番,男性配饰、工具、游戏产品的销量也有显著增长。


数据显示,在2月1日至18日期间,平台的男性用品销售额较1月同比增长了59%。其中,剃须泡沫销量增加了252%,袜子销量增加了135%,内衣则增加了61%。


销量增长之外,订单额也在增加。据OFD(俄罗斯在线收据处理商)数据,在"男人节"前一周的电商销售中,袜子的平均订单额为494卢布(约43人民币),较1月高出36%,较去年同期高出20%。


OFD还表示,俄罗斯人在网上买的袜子多是彩色的或带有印花的,一套8-10双左右。此外,他们购买的袜子都是棉质材料,尺码在25-29之间(男鞋的40-44码)。


男性配饰方面,钱包、领带和皮带的销量分别增加了174%、144%和133%。此外,截至2月23日,衬衫销量增加了54%,增长不明显的原因是衬衫平时的销售也比较好。


工具方面,Wildberries平台的工具包销量增加了125%,螺丝刀和钻头的销量分别增加了101%和62%。


电子产品方面,俄罗斯消费者在给丈夫、父亲或儿子挑选礼物时,一般会选择价格相对较高的电子产品。Wildberries数据显示,"男人节"前夕,游戏机销量增长了267%,平板电脑、音乐耳机、健身手环和手机的销量也有所增长。


除此之外,俄罗斯人还会购买一些便宜但有趣的糖果礼物,这类产品销量增长了255%。蟑螂、扳手、螺丝形状的巧克力成为了该品类的热销品。


虽然今年的"男人节"已过,不过卖家们可以了解一下俄罗斯这个特有的节日,为下一年做足准备。


原文转载:http://www.shaoqun.com/a/596595.html

跨境电商:https://www.ikjzd.com/

易佰:https://www.ikjzd.com/w/1482

墩煌网:https://www.ikjzd.com/w/189


俄罗斯"男人节"由来"男人节"是从俄罗斯的祖国保卫者日衍生出来的。1919年初,为纪念苏俄红军建立,苏俄中央执行委员会决定将2月23日定为节日。1995年,俄罗斯国家杜马将这一节日命名为祖国保卫者日。2002年开始,每逢祖国保卫者日,俄罗斯全国放假一天。在这一天,俄罗斯会举行阅军等隆重仪式。随着时间的流逝,祖国保卫者日逐渐被赋予另一种涵义。俄罗斯人将这一天当成"男人节",并在这一天为身边的男性赠送
出口易:https://www.ikjzd.com/w/1317
camel:https://www.ikjzd.com/w/331.html
yeepay:https://www.ikjzd.com/w/2574
亚马逊新手防坑细节,避免花样"阵亡":https://www.ikjzd.com/home/136019
必看!亚马逊账号被暂停的 6 种常见原因及解决办法:https://www.ikjzd.com/home/21777
又有老板被代运营骗了!:https://www.ikjzd.com/home/132152

估值1000亿美元 !杂货电商弯道超车,成北美最具潜力市场

eMarketer最新的一份报告预测2021年在线杂货销售将超过1000亿美元,对于美国消费者而言,从首次在杂货电商消费到多次在网上购物,线上消费已成为日常购物习惯。


根据eMarketer的报告数据,在线类别的增长速度超出了2020年初的预期。在疫情中,根据该公司对美国杂货销售的最新预测,成千上万的美国消费者首次成为在线杂货消费者。


去年美国在线食品杂货销售增长了54%,达到9582万美元,在美国电子商务总销售中所占的份额为12.0%,在所有食品杂货销售中所占的份额为7.4%。


展望未来,由于疫苗的推出将使消费者回归现实的店铺,因此杂货的电商增长将会放缓。但一部分在线杂货店购物习惯仍将保留,到2021年,消费者的在线杂货购物支出将首次超过1000亿美元。


根据eMarketer的数据,到2023年,在线杂货销售将占美国杂货销售总额的11.2%。


图片1.png


eMarketer高级预测分析师Whitney Birdsall表示:"疫情促使消费者寻求一种安全便捷的方法来获取必需的杂货,而许多零售商都适应了这种需求,开始在线上进行销售。"


"随着提供路边取货服务的商店越来越多,食品杂货送货应用程序的功能也越来越多,消费者现在有了各种各样的选择来在线订购他们的食品杂货。由于方便和安全,在疫情期间首次在网上购买食品杂货的很大一部分消费者现在更喜欢这种购物方式。"


杂货店电子商务销售额的增长在很大程度上可归因于首次消费者进入市场。去年,美国在线杂货店消费者(一年中至少购买过一次)的数量猛增了42.6%,达到1.316亿。eMarketer预计,到2022年,美国一半以上的人口将是数字食品杂货消费者。


图片2.png


eMarketer首席分析师安德鲁·利普斯曼(Andrew Lipsman)表示:"一旦通过疫苗的普及,在很大程度上缓解疫情危机,许多寻求低价购物的消费者将恢复疫情前的购买行为。"


其他消费者现在已经习惯了在网上购买食品杂货的过程。许多养成了网上购物习惯的人会把这种行为延续下去。数字杂货市场的持续增长将更多地取决于购买频率,而不是新买家进入该领域。


人均消费的增加也将推动网上食品杂货销售的增长。eMarketer估计,2020年每位消费者的年支出为728美元,2021年为818美元。预计到2023年,这一数字将超过1000美元。


原文转载:http://www.shaoqun.com/a/596593.html

跨境电商:https://www.ikjzd.com/

勤商网:https://www.ikjzd.com/w/2219

epc:https://www.ikjzd.com/w/488


eMarketer最新的一份报告预测2021年在线杂货销售将超过1000亿美元,对于美国消费者而言,从首次在杂货电商消费到多次在网上购物,线上消费已成为日常购物习惯。根据eMarketer的报告数据,在线类别的增长速度超出了2020年初的预期。在疫情中,根据该公司对美国杂货销售的最新预测,成千上万的美国消费者首次成为在线杂货消费者。去年美国在线食品杂货销售增长了54%,达到9582万美元,在美国电
海带宝:https://www.ikjzd.com/w/1548
沃尔码:https://www.ikjzd.com/w/220
hts:https://www.ikjzd.com/w/525
为什么说选品就是在选关键词?:https://www.ikjzd.com/home/137261
卖家信息被测评服务商内部泄露遇骚扰?:https://www.ikjzd.com/home/130962
1688跨境专供设全球商品库:大数据指导选品:https://www.ikjzd.com/home/18255

C#实现JWT无状态验证的实战应用

前言

本文主要介绍JWT的实战运用。

准备工作

首先我们创建一个Asp.Net的,包含MVC和WebApi的Web项目。

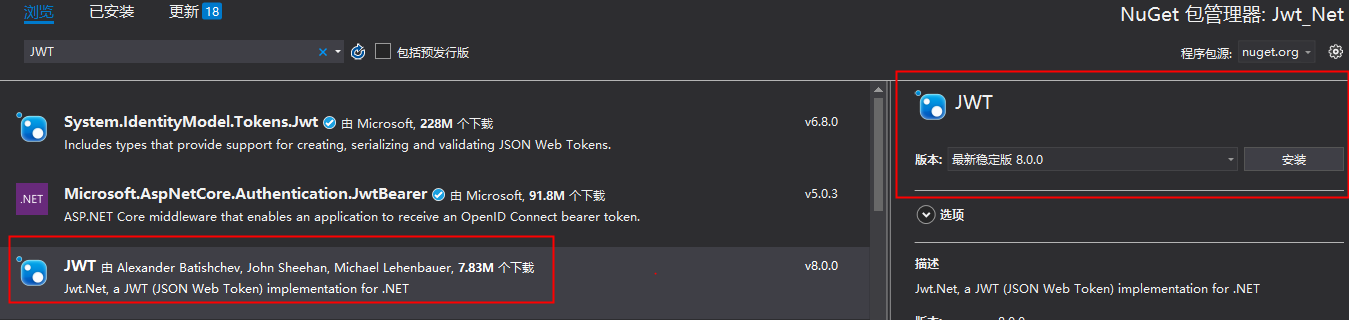
然后使用Nuget搜索JWT,安装JWT类库,如下图。
设计思路

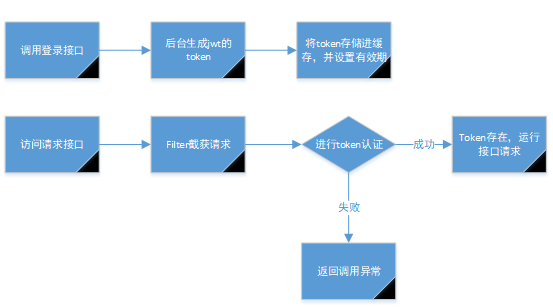
这里我们简单的做了一个token验证的设计,设计思路如下图所示:
代码实现

缓存

首先,我们先开发工具类,根据设计思路图可得知,我们需要一个缓存类,用于在服务器端存储token。

编写缓存相关类代码如下:

 public class CacheHelper {  public static object GetCache(string key)  {   return HttpRuntime.Cache[key];  }​  public static T GetCache<T>(string key) where T : class  {   return (T)HttpRuntime.Cache[key];  }​  public static bool ContainsKey(string key)  {   return GetCache(key) != null;  }​  public static void RemoveCache(string key)  {   HttpRuntime.Cache.Remove(key);  }​  public static void SetKeyExpire(string key, TimeSpan expire)  {   object value = GetCache(key);   SetCache(key, value, expire);  }​  public static void SetCache(string key, object value)  {   _SetCache(key, value, null, null);  }​  public static void SetCache(string key, object value, TimeSpan timeout)  {   _SetCache(key, value, timeout, ExpireType.Absolute);  }​  public static void SetCache(string key, object value, TimeSpan timeout, ExpireType expireType)  {   _SetCache(key, value, timeout, expireType);  }​  private static void _SetCache(string key, object value, TimeSpan? timeout, ExpireType? expireType)  {   if (timeout == null)    HttpRuntime.Cache[key] = value;   else   {    if (expireType == ExpireType.Absolute)    {     DateTime endTime = DateTime.Now.AddTicks(timeout.Value.Ticks);     HttpRuntime.Cache.Insert(key, value, null, endTime, Cache.NoSlidingExpiration);    }    else    {     HttpRuntime.Cache.Insert(key, value, null, Cache.NoAbsoluteExpiration, timeout.Value);    }   }  } } /// <summary> /// 过期类型 /// </summary> public enum ExpireType {  /// <summary>  /// 绝对过期  /// 注:即自创建一段时间后就过期  /// </summary>  Absolute,​  /// <summary>  /// 相对过期  /// 注:即该键未被访问后一段时间后过期,若此键一直被访问则过期时间自动延长  /// </summary>  Relative, }​

如上述代码所示,我们编写了缓存帮助类—CacheHelper类。

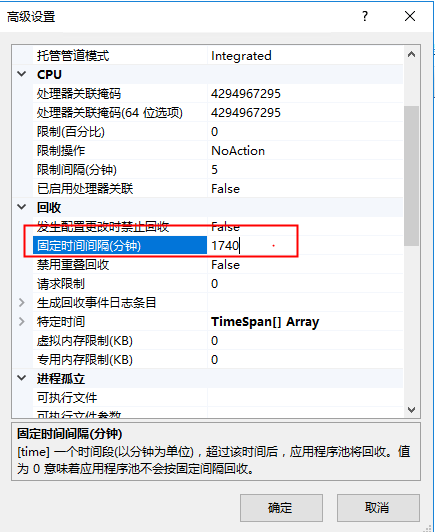
CacheHelper类:使用HttpRuntime的缓存,类里实现缓存的增删改,因为使用的是HttpRuntime,所以,如果没有设置缓存的超时时间,则缓存的超时时间等于HttpRuntime.Cache配置的默认超时时间。

如果网站挂载在IIS里,那么,HttpRuntime.Cache配置超时时间的地方在该网站的应用程序池中,如下图:
Jwt的帮助类

现在我们编写Jwt的帮助类,代码如下:

public class JwtHelper{ //私钥  public const string secret = "MIGfMA0GCSqGSIb3DQEBAQUAA4GNAmD7RTE2drj6hf3oZjJpMPZUQ1Qjb5H3K3PNwIDAQAB";  /// <summary> /// <summary> /// 生成JwtToken /// </summary> /// <param name="payload">不敏感的用户数据</param> /// <returns></returns> public static string SetJwtEncode(string username,int expiresMinutes) {  //格式如下  var payload = new Dictionary<string, object>  {   { "username",username },   { "exp ", expiresMinutes },   { "domain", "" }  };​  IJwtAlgorithm algorithm = new HMACSHA256Algorithm();  IJsonSerializer serializer = new JsonNetSerializer();  IBase64UrlEncoder urlEncoder = new JwtBase64UrlEncoder();  IJwtEncoder encoder = new JwtEncoder(algorithm, serializer, urlEncoder);​  var token = encoder.Encode(payload, secret);   return token; }  /// <summary> /// 根据jwtToken 获取实体 /// </summary> /// <param name="token">jwtToken</param> /// <returns></returns> public static IDictionary<string,object> GetJwtDecode(string token) {  IJsonSerializer serializer = new JsonNetSerializer();  IDateTimeProvider provider = new UtcDateTimeProvider();  IJwtValidator validator = new JwtValidator(serializer, provider);  IBase64UrlEncoder urlEncoder = new JwtBase64UrlEncoder();  IJwtAlgorithm algorithm = new HMACSHA256Algorithm();  IJwtDecoder decoder = new JwtDecoder(serializer, validator, urlEncoder, algorithm);  var dicInfo = decoder.DecodeToObject(token, secret, verify: true);//token为之前生成的字符串  return dicInfo; }} 

代码很简单,实现了JWT的Code的创建和解析。

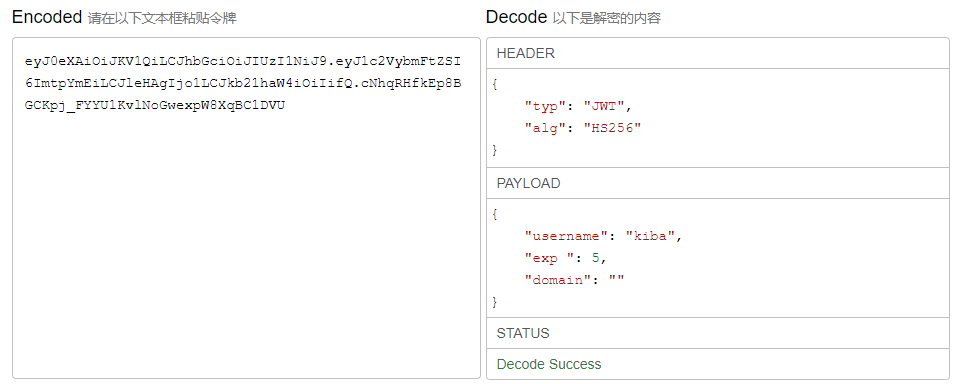
注:JWT的Code虽然是密文,但它是可以被解析的,所以我们不要在Code里存储重要信息,比如密码。

JWT的Code与解析后的内容如下图所示,左边未Code,右边未解析的内容。
AuthenticationHelper验证帮助类

现在,我们已经可以编写验证类了,利用刚刚已创建的缓存帮助类和JWT帮助类。

AuthenticationHelper验证帮助类代码如下:

 public class AuthenticationHelper {  /// <summary>  /// 默认30分钟  /// </summary>  /// <param name="username"></param>  public static void AddUserAuth(string username)  {   var token = JwtHelper.SetJwtEncode(username, 30);   CacheHelper.SetCache(username, token, new TimeSpan(TimeSpan.TicksPerHour / 2));  }  public static void AddUserAuth(string username, TimeSpan ts)  {   var token = JwtHelper.SetJwtEncode(username, ts.Minutes);   CacheHelper.SetCache(username, token, ts);​  }  public static string GetToken(string username)  {   var cachetoken = CacheHelper.GetCache(username);   return cachetoken.ParseToString();  }  public static bool CheckAuth(string token)  {   var dicInfo = JwtHelper.GetJwtDecode(token);   var username = dicInfo["username"];​   var cachetoken = CacheHelper.GetCache(username.ToString());   if (!cachetoken.IsNullOrEmpty() && cachetoken.ToString() == token)   {    return true;   }   else   {    return false;   }  } }

如代码所示,我们实现了验证token创建、验证token获取、验证Token校验三个方法。


到此,我们的基础代码已经编写完了,下面进入验证的应用。

Fliter

首先,在Global.asax文件中,为我们WebApi添加一个过滤器,代码如下:

 public class WebApiApplication : System.Web.HttpApplication {  protected void Application_Start()  {   AreaRegistration.RegisterAllAreas();   GlobalConfiguration.Configure(WebApiConfig.Register);   //webapiFilter   System.Web.Http.GlobalConfiguration.Configuration.Filters.Add(new HttpPermissionFilter());   System.Web.Http.GlobalConfiguration.Configuration.Filters.Add(new HttpExceptionFilter());   //mvcFliter   System.Web.Mvc.GlobalFilters.Filters.Add(new MvcExceptionFilter());   System.Web.Mvc.GlobalFilters.Filters.Add(new MvcPermissionFilter());   RouteConfig.RegisterRoutes(RouteTable.Routes);   BundleConfig.RegisterBundles(BundleTable.Bundles);  } } 

代码中创建了四个过滤器,分别是MVC的请求和异常过滤器和WebApi的请求和异常过滤器。

这里我们主要看WebApi的请求过滤器——HttpPermissionFilter。代码如下:

public class HttpPermissionFilter : System.Web.Http.Filters.ActionFilterAttribute{ public override void OnActionExecuting(HttpActionContext actionContext) {  string url ="请求Url" + actionContext.Request.RequestUri.ToString();   var action = actionContext.ActionDescriptor.ActionName.ToLower();  var controller = actionContext.ControllerContext.ControllerDescriptor.ControllerName.ToLower();  if (controller != "login" && controller != "loginout")  {    //客户端段token获取   var token = actionContext.Request.Headers.Authorization != null ? actionContext.Request.Headers.Authorization.ToString() : "";   //服务端获取token 与客户端token进行比较   if (!token.IsNullOrEmpty() && AuthenticationHelper.CheckAuth(token))   {    //认证通过,可进行日志等处理    }   else   {     throw new Exception("Token无效");   }   } }}

我们的HttpPermissionFilter类继承了System.Web.Http.Filters.ActionFilterAttribute,这样他就可以截获所有的WebApi请求了。

然后我们重写了他的OnActionExecuting方法,在方法里,我们查询到当前请求的Controller的名称,然后对其进行了一个简单的判断,如果是login(登录)或loginout(登出),那我们就不对他的token进行验证。如果是其他请求,则会从请求的Headers的Authorization属性里读取token,并使用AuthenticationHelper类对这个token进行正确性的验证。

WebApi接口

现在我们编写WebApi接口,编写一个登录接口和一个普通请求接口。

登录接口:这里我们使用AuthenticationHelper类创建一个token,并把他存储到缓存中。

然后再把token返回给调用者。

普通接口:这里我们不做任何操作,就是简单的返回成功,因为是否可以访问这个接口,已经又Filter控制了。

代码如下:

public class LoginController : ApiController{  public string Get(string username,string pwd) {  AuthenticationHelper.AddUserAuth(username, new TimeSpan(TimeSpan.TicksPerMinute * 5));//5分钟   string token = AuthenticationHelper.GetToken(username);  return token; } }public class RequestController : ApiController{  public string Get() {  return "请求成功"; } } 

测试页面

现在我们编写测试页面,这里我们实现三个按钮,登录、带token访问Api、无token访问Api。

代码如下:

<div>  <script>  $(document).ready(function () {   $("#request").click(function () {    var token = window.localStorage.getItem('token');    if (token) {​     $.ajax({      type: "GET",      url: "http://localhost:50525/api/Request",      success: function (data) {       $('#con').append('<div> success:' + data + '</div>');       console.log(data);      },      beforeSend: function (xhr) {       //向Header头中添加Authirization       xhr.setRequestHeader("Authorization", token);      },      error: function (

测试结果如下:
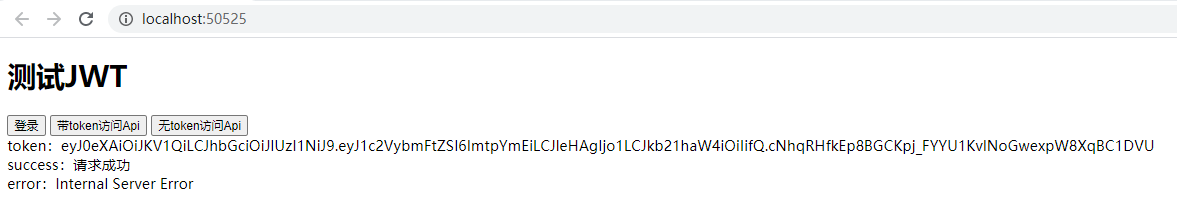
如上图所示,我们已经成功实现简单的token验证。

----------------------------------------------------------------------------------------------------

到此JWT的实战应用就已经介绍完了。

代码已经传到Github上了,欢迎大家下载。

Github地址: https://github.com/kiba518/JwtNet

----------------------------------------------------------------------------------------------------

注:此文章为原创,任何形式的转载都请联系作者获得授权并注明出处!
若您觉得这篇文章还不错,请点击下方的【推荐】,非常感谢!

https://www.cnblogs.com/kiba/p/14461836.html


原文转载:http://www.shaoqun.com/a/596585.html

跨境电商:https://www.ikjzd.com/

首信易:https://www.ikjzd.com/w/1841

易趣:https://www.ikjzd.com/w/210


前言本文主要介绍JWT的实战运用。准备工作首先我们创建一个Asp.Net的,包含MVC和WebApi的Web项目。然后使用Nuget搜索JWT,安装JWT类库,如下图。设计思路这里我们简单的做了一个token验证的设计,设计思路如下图所示:代码实现缓存首先,我们先开发工具类,根据设计思路图可得知,我们需要一个缓存类,用于在服务器端存储token。编写缓存相关类代码如下:publicclassCac
lastpass:https://www.ikjzd.com/w/846
手机trademanager:https://www.ikjzd.com/w/730
reddit:https://www.ikjzd.com/w/180
曝料:Etsy因支付故障问题,卖家银行账户惨遭清空!:https://www.ikjzd.com/home/16827
口述:我沦为美貌老婆的"男奴":http://lady.shaoqun.com/m/a/10354.html
海关查验神器H986:出此港必查!还敢瞒报、谎报?:https://www.ikjzd.com/home/98596

有没有妇科病,下面的毛发会告诉你!

核心提示:女人私处毛发的情况,透露了子宫以及卵巢的健康程度,私处毛发的多少、颜色变化,都与女性健康息息相关。

提到私处的毛发,很多女性都有点不解:"弯弯曲曲的太丑了,长了到底有什么用?",事实上,阴毛可以抵御细菌和病毒入侵皮肤或者体内的,从而防止性病互相传染。除了这个作用,女人私处毛发的情况,透露了子宫以及卵巢的健康程度,私处毛发的多少、颜色变化,都与女性健康息息相关。


一、毛发过少

女人私处和腋下毛发都少时,不要庆幸省去了脱毛的麻烦,而是要担心卵巢有问题。先天卵巢发育不良或者卵巢提前衰退的人,会表现出私处毛发稀少,而且通常还会伴有性冷淡和生育能力低下等表现。所以,平时一定要注重对卵巢的保养。

二、毛发脱落

阴毛会自然脱落,大约每半年更换一次,所以能经常在家中看到这些掉落的毛发。随着年龄的增长,阴毛脱落也会越来越多,到了一定年龄,阴毛变得稀少,是正常现象。但如果年纪年轻的女人,出现这样的情况,要考虑卵巢功能低下的问题。

三、私处毛发过多

有些女性私处毛发异常多,一般是疾病的表现,并不一定就是性需求强烈。患有垂体腺瘤的女性,阴毛变多,往往还会出现肚子变大、闭经等症状。患肾上腺皮质过度增生及肿瘤的女人,雄性激素分泌太多,导致阴毛过多。

四、颜色变化


当私处毛发颜色由黑色变白时,那是体内黑色素减少,可能是由于营养不良或精神压力大,还要考虑是白化病导致的。如果出现黄色或者红色,那都有可能是营养不良或者是年龄增大造成的。

五、有附着物

阴毛上出现有颜色的物体,那有可能是感染了细菌,一般是黄、红、黑这三种颜色,那是阴毛癣。如果有灰白色的小颗粒物体,而且出现阴部瘙痒、红色斑点时则是由阴虱引起的,需要及时治疗。


原文转载:http://health.shaoqun.com/a/188079.html

跨境电商:https://www.ikjzd.com/

shopyy:https://www.ikjzd.com/w/1661

barclays:https://www.ikjzd.com/w/2775


核心提示:女人私处毛发的情况,透露了子宫以及卵巢的健康程度,私处毛发的多少、颜色变化,都与女性健康息息相关。 提到私处的毛发,很多女性都有点不解:"弯弯曲曲的太丑了,长了到底有什么用?",事实上,阴毛可以抵御细菌和病毒入侵皮肤或者体内的,从而防止性病互相传染。除了这个作用,女人私处毛发的情况,透露了子宫以及卵巢的健康程度,私处毛发的多少、颜色变化,都与女性健康息息相关。一、毛发过少女人私处和腋下毛
6pm:https://www.ikjzd.com/w/317
cima是什么:https://www.ikjzd.com/w/1372
auditor:https://www.ikjzd.com/w/2437
口述:一年没怀孕我跪着向婆婆说明缘由:http://lady.shaoqun.com/m/a/73755.html
口述:闺蜜大胸撑破内衣 老公羡慕不已:http://lady.shaoqun.com/m/a/18625.html
两大深圳卖家老板出境,央视走进跨境电商行业!:https://www.ikjzd.com/home/113321

家有红/紫药水赶紧扔掉,不但不能处理好伤口,还可能对身体有害

核心提示:在生活中,我们可以在家中准备一些像碘伏、碘酒、酒精、生理盐水等药品来应急处理一些外伤,这些药物对伤口处理都是非常有效的。但是如果伤口很大,或者污染很严重,就需要到医院由医师进行专业的处理,不要自行处置。

人生在世难免磕着碰着,碘伏、碘酒、酒精、红药水、紫药水,总有一个家中常备。但是有时候真的不好选择,这么多药水,究竟用哪个最有效呢?

今天,小妙就来跟大家好好说说。

一、碘伏

碘伏是一种常用的消毒剂,基本上家中常备、

碘伏对人体毒性低,却有很强的杀菌作用,能杀灭包括细菌、原虫、真菌和部分病毒。另外,碘伏对人皮肤的刺激性小,涂擦伤口时痛感较轻,因此碘伏适用范围很广。

除此之外,碘伏可用于脸部的美容清洁和消炎,例如脸上患有痤疮、酒糟鼻的患者,就可以用碘伏稀释液进行日常涂抹;碘伏还能用于家中日常用品与时鲜蔬果的消毒,能去除大部分细菌和病菌。 当然,关于这一点,小妙应该是不会的,虽然它的效果很好,但是小妙心里多少有点过不去。

除了清理皮肤外伤口,碘伏还可用于治疗甲沟炎和妇科炎症等疾病。在甲沟炎发生的早期,患处涂抹碘伏擦洗有利于预防后续的感染,防止进一步化脓。对于阴道炎、宫颈糜烂等妇科疾病,用碘伏擦洗会阴切口能有效减轻疼痛,预防感染。

二、碘酒

碘酒又名碘酊,是由碘化钾等物质溶于酒精和水后产生的一种消毒液。其作用机制是使菌体蛋白质变性并死亡,对细菌、真菌和病毒都有灭杀作用[1]。但是碘酒对人体的刺激性比较强,如果用在伤口上会造成较为剧烈的痛感,还可能灼伤皮肤组织。因此碘酒主要用于表皮的消毒工作。

除了消毒皮肤外,碘酒可以治疗一些封闭性的毛囊炎,或被蚊虫叮咬后产生的小包。这些情况不会产生伤口,因此可以用碘酒涂抹患处,刺激皮肤促进血液循环。

由于碘酒对皮肤和黏膜都有较强的刺激性,因此即便不是在伤口上使用,在进行皮肤消毒时也要先用酒精进行脱碘。具体做法是先用棉签在皮肤上涂擦一遍碘酒,过一分钟后再用医用酒精擦拭两遍。

三、酒精

看过武侠片的人都知道,当电视剧中的主角受了伤之后,旁边的人都会口含一口白酒,朝着它的伤口喷过去,其实这也就是现在的酒精消毒。

医用酒精一般指含有75%乙醇的液体,能够进行伤口的消毒,阻止细菌和病毒进入体内。酒精的利用范围很广,尤其是在新冠病毒流行的当下,酒精能够消毒皮肤和双手,也可以用酒精喷雾对衣物和用品进行消毒。

不同浓度的酒精利用范围不同,95%浓度的酒精可用于清洁相机镜头,40%~50%的酒精可以擦拭皮肤促进血液循环。75%浓度的酒精消毒效果最佳,但要避免直接对皮肤破溃处使用酒精,因为乙醇对伤口的刺激性还是比较强的。

使用酒精时要特别注意远离火源,因为酒精是易挥发、易燃的化学物质。此外家中不宜存放大量的医用酒精,每次用完之后要记得盖紧瓶盖,以免发生意外。

听完小妙科普了上面3种药物,你知道选择哪个了吗?

四、为什么红/紫药水被淘汰?

说完了上面3种消毒药水,你有没有发现好像少了些什么?

从前我们小时候用的红、紫药水似乎并没有提到,而且现在见到的也少了。除了部分家庭还在使用外,医院基本淘汰掉了这两种药水,这是怎么回事呢?

其实那是因为随着现代研究发现,小时候常用的红药水是2%的汞溴红溶液,是一种消毒防腐药[2]。但它的穿透性很弱,因此抑菌作用也并不显著。最重要的是,红药水中含有汞,对人体是有毒的,长期使用可能致癌。

紫药水是用化学药品龙胆紫配制而成的稀释溶液,其杀菌力强于红药水,且对人体无害。但紫药水对革兰氏阴性细菌不敏感,因此无法杀灭所有的细菌。

五、补充:皮肤擦伤,如何正确的处理伤口?

科普完了一些常用的消毒药物,小妙自然不会忘记科普一些皮肤擦伤的处理措施,毕竟夏天要到了,磕着碰着在所难免。

简单的皮肤擦伤,大家只需要做好2步。首先用上述小妙推荐的药物,进行伤口的清创消毒,也就是用这些药物进行擦拭,清除血迹和不干净的灰尘等等。

其次,要注意在伤口的恢复期间不要沾水。

而严重的皮肤擦伤,病人在结痂恢复期,还可以热敷,也可以也可以配合应用抗炎止痛的药物、活血化瘀药物促进恢复。

在生活中,我们可以在家中准备一些像碘伏、碘酒、酒精、生理盐水等药品来应急处理一些外伤,这些药物对伤口处理都是非常有效的。但是如果伤口很大,或者污染很严重,就需要到医院由医师进行专业的处理,不要自行处置。

参考资料:

[1]杨筱筠 ;李平.碘伏的妙用[J].开卷有益:求医问药.2018-02-22

[2]朱俊平.碘伏 酒精 碘酒 三种消毒剂该如何选择[J].糖尿病之友.2012-04-41

[3]曹继红;咸红金.酒精用于开放性伤口的临床探索[J].中国社区医师(医学专业半月刊).2008


[4]罗春梅.红药水 紫药水要适可而用[J].健康伴侣.2008

[5]【快看·健康】受伤后该如何正确处理伤口?一起来学学.央视网.2020-03-17

未经作者允许授权,禁止转载


原文转载:http://health.shaoqun.com/a/188071.html

跨境电商:https://www.ikjzd.com/

bestbuy:https://www.ikjzd.com/w/394

出口易:https://www.ikjzd.com/w/1317


核心提示:在生活中,我们可以在家中准备一些像碘伏、碘酒、酒精、生理盐水等药品来应急处理一些外伤,这些药物对伤口处理都是非常有效的。但是如果伤口很大,或者污染很严重,就需要到医院由医师进行专业的处理,不要自行处置。 人生在世难免磕着碰着,碘伏、碘酒、酒精、红药水、紫药水,总有一个家中常备。但是有时候真的不好选择,这么多药水,究竟用哪个最有效呢?今天,小妙就来跟大家好好说说。一、碘伏碘伏是一种常用的消
auditor:https://www.ikjzd.com/w/2437
欧苏丹:https://www.ikjzd.com/w/1756
55海淘:https://www.ikjzd.com/w/1723
亚马逊新政:指定的卖家才能卖口罩 其他人申请不批:https://www.ikjzd.com/home/118073
口述:丈夫出轨还不认 怨妻被迫当情探(4/4):http://lady.shaoqun.com/m/a/41350.html
电商早报0403丨万事达卡投资Jumia 5600万美元:https://www.ikjzd.com/home/20944

西乙-武磊时隔三轮替补登场 西班牙人1-1希洪竞技_禁区

原标题:西乙-武磊时隔三轮替补登场 西班牙人1-1希洪竞技

北京时间2月28日23时,2020-2021赛季西班牙乙级联赛第27轮上演一场焦点战役,西班牙人做客大磨坊球场对阵希洪竞技。本场比赛,中国球星武磊继续在替补席待命,武磊已经连续11轮联赛充当替补。上半场,恩巴尔巴破门为西班牙人首开纪录,随后久尔杰维奇破门扳平比分。武磊在第67分钟替补登场。最终西班牙人1-1战平希洪竞技,继续排名积分榜第二位。

第2分钟,奥斯卡-希尔横向带球突破到禁区左侧,随后倒三角回敲到禁区弧顶,达德尔迎球低射打偏。第8分钟,普阿多前场左路带球突破,被富埃戈拉倒在地,主裁判向富埃戈出示一张黄牌。第12分钟,梅伦多禁区前沿送出直塞,佩德罗萨前插到禁区左侧倒三角回敲,恩巴尔巴中路跟进迎球推射,球打在防守球员的脚下窜入网窝,西班牙人1-0领先。

第19分钟,梅伦多带球突破到禁区正前沿,跑动中起脚低射,角度太正,球被门将没收。第23分钟,巴雷回传失误,球被希洪竞技球员断下,久尔杰维奇前场左路带球突破到禁区前沿,跑动中起脚兜射,皮球击中远侧立柱弹入网窝,1-1。

第32分钟,卡夫雷拉后场左路防守犯规,领到一张黄牌。第34分钟,奥斯卡-希尔禁区右侧突破被绊倒在地,但是主裁判没有任何表示。第42分钟,希洪竞技后场送出过顶长传,久尔杰维奇前插得球后形成单刀,随后突破到禁区左侧推射远角打偏,边裁举旗示意久尔杰维奇越位在先。第45+1分钟,希洪竞技禁区右侧低平球斜传到门前,后点奥斯卡-希尔将球挡出,球打在加斯帕-坎波斯的手臂上,随后加斯帕-坎波斯顺势捅射破门,经过VAR核实,确认加斯帕-坎波斯手球犯规在先,进球无效。

半场战罢,西班牙人暂1-1希洪竞技。

下半场易边再战。第49分钟,佩德罗萨在对方禁区内抢断门将时犯规在先,被主裁判出示了一张黄牌。第51分钟,西班牙人打出一次快速反击,普阿多带球突破到禁区左侧底线前,随后倒三角回敲给迪马塔,迪马塔前点迎球抽射打高。第56分钟,恩巴尔巴开出右路角球至禁区内,卡夫雷拉前点撩射,球打在大卫-洛佩斯的身上弹出底线。

第59分钟,恩巴尔巴前场右路挑传到禁区内,普阿多后点头球冲顶,球稍稍高出横梁。第60分钟,武磊开始在场边进行热身。第61分钟,奥斯卡-希尔前场右路低平球横传到禁区内,达德尔前点得球后顺势扫射,球被门将扑出。第67分钟,西班牙人打出一次快速反击,恩巴尔巴中场右路带球突破被马努-加西亚铲倒在地,马努-加西亚领到一张黄牌。

第67分钟,武磊替补上场换下迪马塔,武磊时隔三轮后再次替补登场。

第72分钟,格拉赫拉将球分给禁区左侧的久尔杰维奇,久尔杰维奇得球后晃开角度起脚低射近角,球被门将迭戈-洛佩斯没收。第74分钟,武磊回撤到中圈将球卸下,准备传给队友打反击,但是主裁判吹罚武磊手球犯规在先。第77分钟,西班牙人打出一次快速反击,恩巴尔巴禁区左侧得球后起脚兜射,球被门将扑出,奥斯卡-希尔禁区右侧跟进起脚补射,球打在横梁上弹出底线。

第78分钟,梅拉梅德替补登场换下梅伦多。第80分钟,奥斯卡-希尔前插到禁区右侧倒三角挑传到门前,后点梅拉梅德头球攻门顶高。第88分钟,武磊前场中路反抢得手,随后带球突破,但是又被对方夺回球权。全场比赛结束,西班牙人1-1希洪竞技。

双方出场阵容:

希洪竞技(4-1-4-1):13-马里尼奥/2-罗萨斯(32-米洛瓦诺夫 71')、6-巴宾、4-瓦连特、3-萨乌尔-加西亚/18-富埃戈/7-埃托尔-加西亚(14-伊格纳西奥-门德斯 86')、16-格拉赫拉、19-马努-加西亚(8-佩德罗-迪亚斯 86')、27-加斯帕-坎波斯(10-卡尔莫纳 78')/23-久尔杰维奇

西班牙人(4-2-3-1):13-迭戈-洛佩斯/27-奥斯卡-希尔(6-尤易斯-洛佩斯 83')、15-大卫-洛佩斯、4-卡夫雷拉、3-佩德罗萨/20-巴雷(8-梅里达 67')、10-达德尔/23-恩巴尔巴(19-巴迪略 84')、14-梅伦多(33-梅拉梅德 78')、9-普阿多/18-迪马塔(7-武磊 67')返回搜狐,查看更多

责任编辑:

原文转载:http://sport.shaoqun.com/a/457741.html

跨境电商:https://www.ikjzd.com/

大森林:https://www.ikjzd.com/w/2268

prezi:https://www.ikjzd.com/w/1751


原标题:西乙-武磊时隔三轮替补登场西班牙人1-1希洪竞技北京时间2月28日23时,2020-2021赛季西班牙乙级联赛第27轮上演一场焦点战役,西班牙人做客大磨坊球场对阵希洪竞技。本场比赛,中国球星武磊继续在替补席待命,武磊已经连续11轮联赛充当替补。上半场,恩巴尔巴破门为西班牙人首开纪录,随后久尔杰维奇破门扳平比分。武磊在第67分钟替补登场。最终西班牙人1-1战平希洪竞技,继续排名积分榜第二位。
飞书互动:https://www.ikjzd.com/w/1319
usps国际快递查询:https://www.ikjzd.com/w/513
blibli:https://www.ikjzd.com/w/1676
捷网国际:https://www.ikjzd.com/w/2172
如何使用Elementor编辑器的facebook Page功能:https://www.ikjzd.com/home/141479
海运整箱和拼箱的成本为什么不一样:https://www.ikjzd.com/home/3741

2021年2月28日星期日

关于Java高并发编程你需要知道的“升段攻略”

关于Java高并发编程你需要知道的"升段攻略"

基础

  1. Thread对象调用start()方法包含的步骤

    1. 通过jvm告诉操作系统创建Thread
    2. 操作系统开辟内存并使用Windows SDK中的createThread()函数创建Thread线程对象
    3. 操作系统对Thread对象进行调度,以确定执行时机
    4. Thread在操作系统中被成功执行
  2. 执行start的顺序不代表执行run的顺序

  3. 执行方法run和start有区别

    1. xxx.run():立即执行run()方法,不启动新的线程
    2. xxx.start():执行run()方法时机不确定,启动新的线程
  4. 线程停止:

    1. public static boolean interrupted():测试当前线程是否已经是中断状态,执行后具有清除状态标志值的功能

    2. public boolean this.isInterrupted():测试当前线程是否已经是中断状态,不清除状态标志

    3. 停止线程-异常

    4. 在sleep下停止线程,当sleep和interrupt同时出现时,会报错

    5. stop终止线程

    6. return停止线程

    7. 暂停线程

      suspend 和 resume独占

  5. synchronized原理:

    1. 方法:使用ACC_SYNCHRONIZED标记
    2. 代码块:使用monitorenter和monitorexit指令
  6. 静态同步synchronized方法与synchronized(class)代码块,同步synchronized方法与synchronized(this)代码块

  7. volatile关键字特性:

    1. 可见性:一个线程修改共享变量的值,其他线程立马就知道
    2. 原子性:double和long数据类型具有原子性,针对volatile声明变量的自增不具有原子性
    3. 禁止代码重排序
  8. 利用volatile关键字解决多线程出现的死循环(可见性),本质是因为线程的私有堆栈和公有堆栈不同步

  9. synchronized代码块具有增加可见性的作用

  10. 自增/自减操作的步骤

    1. 从内存中取值
    2. 计算值
    3. 将值写入内存
  11. 使用Atomic原子类进行i++操作实现原子性

  12. sychronized代码块和volatile关键字都禁止代码重排序:位于代码块/关键字两侧的不能互相重排序,只能各自在前面或者后面重排序

  13. wait/notify机制

    1. 使用前都必须获得锁,即必须位于synchronized修饰的方法内或者代码块内,且必须是同一把锁
    2. 使用wait后会释放锁,当调用notify后,线程再次获得锁并执行
    3. wait执行后会立即释放锁,而notify执行后不会立即让出锁,而是等到执行notify方法的线程将程序执行完以后才让出锁
    4. wait使线程暂停运行,notify使线程继续运行
    5. 处于wait状态下的线程会一直等待
    6. 在调用notify时若没有处于wait状态的线程,命令会被忽略
    7. 当调用了多个wait方法,同时需要多个notify方法时,所有等待的wait状态线程获取锁的顺序是执行wait方法的顺序,即先调用先获得锁
    8. notifyAll方法可以一次通知所有的处理wait状态的线程,但是这些线程获得锁的顺序是先调用的最后获得,后调用的先获得,通常还有其他的顺序,取决于jvm的具体实现
  14. wait立即释放锁,notify不立即释放锁,sleep不会释放锁

  15. wait与interrupt方法同时出现会出现异常

  16. wait(long)表示等待一段时间后,再次获取锁,不需要notify方法通知,若没有获取锁则会一直等待,直到获取锁为止

  17. if+wait建议替换成while+wait

  18. 线程间通过管道通信(字符流/字节流):PipInputStream/PipOutputStream、PipWriter/PipReader

  19. join方法是所属的线程对象x正常执行run()方法中的任务,而使当前线程进行无期限的阻塞,等待线程x销毁后再继续执行线程z后面的代码,具有串联执行的效果

  20. join方法具有使线程排队运行的效果,有类似同步的运行效果,但是join方法与synchronized的区别是join方法内部使用wait方法进行等待(会释放锁),而synchronized关键字使用锁作为同步

  21. join与interrupt同时出现会出现异常

  22. join(long)执行后会调用内部的wait(long)会释放锁,而Thread.sleep(long)则不会释放锁

  23. ThreadLocal

    1. 将数据放入到当前线程对象中的Map中,这个Map是Thread类的实例变量。类ThreadLocal自己不管理、不存储任何数据,它只是数据和Map之间的桥梁,用于将数据放入Map中,执行流程如下:数据-->ThreadLocal-->currentThread() -->Map

    2. 执行后每个线程中的Map存有自己的数据,Map中的key存储的是ThreadLocal对象,value就是存储的值。每个Thread中的Map值只对当前线程可见,其他线程不可以访问。当前线程销毁,Map随之销毁,Map中的数据如果没有被引用、没有被使用,则随时GC回收

    3. 线程、Map、数据之间的关系可以做如下类比:

      人(Thread)随身带有兜子(Map),兜子(Map)里面有东西(Value),这样,Thread随身也有数据,随时可以访问自己的数据

    4. 可以通过继承类,并重写initialValue()来解决get()返回null的问题

    5. Thread本身不能实现子线程使用父线程的值,但是使用InheritableLocalThread则可以访问,不过,不能实现同步更新值,也就是说子线程更新了值,父线程中还是旧值,父线程更新了值,子线程中还是旧值

    6. 通过重写InheritableLocalThread的childValue可以实现子线程对父线程继承的值进行加工修改

  24. Java多线程可以使用synchronized关键字来实现线程同步,不过jdk1.5新增加的ReentrantLock类可能达到同样的效果,并且在扩展功能上更加强大,如具有嗅探锁定、多路分支通知等功能

  25. 关键字synchronized与wait()、notify()/notifyAll()方法相结合可以实现wait/notify模型,ReentrantLock类也可以实现同样的功能,但需要借助于Condition对象。Condition类是jdk5的技术,具有更好的灵活性,例如,可以实现多路通知功能,也就是在一个Lock对象中可以创建多个Condition实例,线程对象注册在指定的Condition中,从而可以有选择性的进行线程通知,在调度线程上更加灵活;在使用notify()/notifyAll()方法进行通知时,被通知的线程有jvm进行选择,而方法notifyAll()会通知所有waiting线程,没有选择权,会出现相当大的效率问题,但使用ReentrantLock结合Condition类可以实现"选择性通知",这个功能是Condition默认提供的

  26. Condition类

    1. Condition对象的创建是使用ReentrantLoack的newCondition方法创建的
    2. Condition对象的作用是控制并处理线程的状态,它可以使线程呈wait状态,也可以让线程继续运行
    3. 通过Condition中的await/signal可以实现wait/notify一样的效果
      1. Object中的wait方法相当于Condition类中的await方法
      2. Object中的wait(long timeout)方法相当于Condition类中的await(long time, TimeUnit unit)方法
      3. Object中的notify方法相当于Condition类中的signal1方法
      4. Object类中的notifyAll方法相当于Condition类中的signalAll方法
    4. await方法暂停线程的原理
      1. 并发包内部执行了unsafe类中的public native void park(boolean isAbsolute, long time)方法,让当前线程呈暂停状态,方法参数isAbsolute代表是否为绝对时间
    5. 公平锁:采用先到先得的锁,每次获取之前都会检查队列里面有没有排队等待的线程,没有才尝试获取锁,如果有就将当前线程追加到队列中
    6. 非公平锁:采用"有机会插队"的策略,一个线程获取之前要先尝试获取锁而不是在队列中等待,如果获取成功,则说明线程虽然是启动的,但先获得了锁,如果没有获取成功,就将自身添加到队列中进行等待
    7. 线程执行lock方法后内部执行了unsafe.park(false, 0L)代码;线程执行unlock方法后内部执行unsafe.unpark(bThread)方法
    8. public int getHoldCount()查询"当前线程"保持锁定的个数,即调用lock方法的次数
    9. public final int getQueueLength()返回正等待获取此锁的线程估计数,例如,这里有5个线程,其中1个线程长时间占有锁,那么调用getQueueLength()方法后,其返回值是4,说明有4个线程同时在等待锁的释放
    10. public int getWaitQueueLength()返回等待与此锁有关的给定条件Condition的线程统计数。例如,有5个线程,每个线程都执行了同一个Condition对象的await()方法,则调用getWaitQueueLength()方法时,其返回的值是5
    11. public final boolean hasQueueThread(Thread thread)查询指定的线程是否正在等待获取此锁,也就是判断参数中的线程是否在等待队列中
    12. public final boolean hasQueueThreads()查询是否有线程正在等待获取此锁,也就是等待队列中是否有等待的线程
    13. public boolean hasWaiters(Condition condition)查询是否有线程正在等待与此锁有关的condition条件,也就是是否有线程执行了condition对象中的await方法而呈等待状态。而public int getWaitQueueLength(Condition condition)方法是返回有多少个线程执行了condition对象中的await方法而呈等待状态
    14. public final boolean isFair()判断是不是公平锁
    15. public boolean isHeldByCurrentThread()是查询当前线程是否保持此锁
    16. public boolean isLocked()查询此锁是否由任意线程保持,并没有释放
    17. public void lockInterruptibly()当某个线程尝试获取锁并且阻塞在lockInterruptibly()方法时,该线程可以被中断
    18. public boolean tryLock()嗅探拿锁,如果当前线程发现锁被其他线程持有,则返回false,程序继续执行后面的代码,而不是呈阻塞等待锁的状态
    19. public boolean tryLock(long timeout, TimeUnit unit)嗅探拿锁,如果当前线程发现锁被其他线程持有了,则返回false,程序继续执行后面的代码,而不是呈阻塞等待状态。如果当前线程在指定的timeout内持有了锁,则返回值是true,超过时间则返回false。参数timeout代表当前线程抢锁的时间
    20. public boolean await(long time, TimeUnit unit)和public final native void wait(long timeout)方法一样,都具有自动唤醒线程的功能
    21. public long awaitNanos(long nanoTimeout)和public final native void wait(long timeout)方法一样,都具有自动唤醒线程的功能,时间单位是纳秒(ns)。
    22. public boolean awaitUntil(Date deadline)在指定的Date结束等待
    23. public void awaitUninterruptibly()在实现线程在等待的过程中,不允许被中断
  27. ReentrantReadWriteLock类

    1. ReentrantLock类具有完全互斥排他的效果,同一时间只有一个线程在执行ReentrantLock.lock()方法后面的任务,这样做虽然保证了同时写实例变量的线程安全性,但效率非常低下,所以jdk提供了一种读写锁——ReentrantReadWriteLock类,使用它可以在进行读操作时不需要同步执行,提升运行速度,加快运行效率
    2. 读写锁有两个锁:一个是读操作相关的锁,也称共享锁;另一个是写操作相关的锁,也称排他锁
    3. 读写互斥,写读互斥,写写互斥,读读异步
  28. Timer定时器

    1. 定时/计划任务功能在Java中主要使用Timer对象实现,它在内部使用多线程的方式进行处理,所以它和线程技术有很大的关联
    2. 在指定的日期执行任务:schedule(TimerTask task, Date firstTime, long period)
    3. 按指定周期执行任务:schedule(TimerTask task, long delay, long period)
    4. 注意:在创建Timer对象时会创建一个守护线程,需要手动关闭,有两种方法
      1. new Timer().concel():将任务队列中的任务全部清空
      2. new TimerTask().concel():仅将自身从任务队列中清空
    5. scheduleAtFixedRate()具有追赶性,也就是若任务的启动时间早于当前时间,那么它会将任务在这个时间差内按照任务执行的规律执行一次,相当于"弥补"流逝的时间
    6. 但timer队列中有多个任务时,这些任务执行顺序的算法是每次将最后一个任务放入队列头,再执行队列头TimerTask任务的run方法
  29. 单例模式与多线程

    1. 饿汉式
    2. 懒汉式
      1. 使用DCL(双重检查锁)来实现(volatile+synchronized)

进阶

并发编程的进阶问题

  1. 并发执行程序一定比串行执行程序快吗?

    答:不是的。因为线程有创建和上下文切换的开销,所以说,在某种情况下线并发执行程序会比串行执行程序慢

  2. 上下文切换:cpu通过时间片分配算法来循环执行任务,当前任务执行一个时间片后会切换到下一个任务。但是,在切换前会保存是一个任务的状态,以便于下次切换回这个任务时,可以再加载这个任务的状态,故任务从保存到再加载的过程就是一次上下文切换。这就像我们同时读两本书,当我们在第一本英文的技术书时,发现某个单词不认识,于是便打开英文字典,但是放下英文技术书之前,大脑必须记住这本书读到了多少页的多少行,等查完单词后,能够继续读这本书。这样的切换是会影响读书效率的,同样上下文切换也会影响多线程的执行速度

  3. 减少上下文切换:

    1. 无锁并发编程。多线程竞争锁时,会引起上下文切换,所以多线程处理数据时,可以用一些办法来避免使用锁,如将数据的id按照Hash算法取模分段,不同的线程处理不同段的数据
    2. CAS算法。Java的Atomic包使用CAS算法来更新数据,而不需要加锁
    3. 使用最少线程。避免创建不需要的线程,比如任务少,但是创建了很多线程来处理,这样会造成大量线程都处于等待状态
    4. 协程:在单线程里实现多任务的调度,并在单线程里维持多个任务间的切换

Java并发机制的底层实现原理

关于volatile

  1. Java代码在编译后会变成Java字节码,字节码被类加载器加载到jvm里,jvm执行字节码,最终需要转化为汇编指令在CPU上执行,Java中所有的并发机制依赖于jvm的实现和CPU的命令
  2. volatile是轻量级的synchronized,它在多处理器开发中保证了共享变量的"可见性"。可见性的意思是当一个线程修改一个共享变量时另外一个线程能读到这个修改的值。如果volatile变量修饰符使用恰当的话,它比synchronized的使用和执行成本更低,因为它不会引起线程上下文的切换和调度
  3. volatile的定义:Java编程语言允许线程访问共享变量,为了确保共享变量能被准确和一致地更新,线程应该确保排他锁单独获得这个变量
  4. 相关CPU的术语定义
    1. 内存屏障(memory barries):是一组处理器指令,用于实现对内存操作的顺序限制
    2. 缓冲行(cache line):缓存中可以分配的最小储存单元。处理器填写缓存线时会加载整个缓存线,需要使用多个主内存读周期
    3. 原子操作(atomic operations):不可中断的一个或一系列操作
    4. 缓存行填充(cache line fill):当处理器识别到从内存中读取操作数是可缓存的,处理器读取整个缓存行到适当的缓存
    5. 缓存命中(cache hit):如果进行高速缓存填充操作的内存位置仍然是下次处理器访问的地址时,处理器从缓存中读取数据,而不是从内存读取
    6. 写命中(write hit):当处理器将操作数写回到一个内存缓存的区域时,它首先会检查这个缓存的内存地址是否在缓存行中,如果存在一个有效的缓存行,则处理器将这个操作数写回到缓存,而不是写回到内存
    7. 写缺失(write misses the cache):一个有效的缓存行被写入到不存在的内存区域
  5. volatile底层通过使用lock前缀的指令来保证可见性,lock前缀的指令在多核处理器下会引发两件事情:
    1. 将当前处理器缓存行的数据写回到系统内存
    2. 这个写回内存操作会使其他CPU里缓存了该内存地址的数据无效

原子操作

原子操作(atomic operation):不可中断的一个或一系列操作

  1. 相关的CPU术语
    1. 缓存行(cache line):缓存的最小操作单位
    2. 比较并交换(compare and swap):CAS操作需要输入两个数值,一个旧值和新值,在操作期间先比较旧值有没有发生变化,若没有发生变化才交换成新值,发生了变化则不交换
    3. CPU流水线(CPU pipeline):CPU流水线的工作方式就像工业生产上的装配流水线,在CPU中由56个不同功能的电路单元组成一条指令处理流水线,然后将x86指令分成56步后再由这些电路单元分别执行,这样就能实现在一个CPU时钟周期完成一条指令,因此提高CPU的运算速度
    4. 内存顺序冲突(memory order violation):内存顺序冲突一般是由假共享引起的,假共享是指多个CPU同时修改同一个缓存行的不同部分而引起其中一个CPU的操作无效,当出现这个内存顺序冲突时,CPU必须清空流水线
  2. 处理器提供总线锁定和缓存锁定两个机制来保证复杂内存操作的原子性
    1. 总线锁就是使用处理器提供的一个LOCK#信号,当一个处理器在总线上输出此信号时,其他处理器的请求被阻塞住,该处理器独占内存。例如:当多个线程执行i++操作时,多个处理器同时从各自的缓存中读取变量i,分别进行加1操作,然后分别写入系统内存中。那么,想要保证读改写共享变量的操作是原子的,就必须保证CPU1读改写共享变量的时候,CPU2不能操作缓存了该共享变量内存地址的缓存
    2. 频繁使用的内存会缓存在处理器的L1、L2和L3高速缓存里,那么原子操作就可以直接在处理器内部缓存中进行,并不需要声明总线锁。缓存锁定是指内存区域如果被缓存在处理器的缓存行中,并且在LOCK期间被锁定,那么但它执行锁操作回写到内存时,处理器不在总线上声言LOCK#信号,而是修改内部的内存地址,并允许它的缓存一致机制来保证操作的原子性,因为缓存一致性机制会阻止同时修改由两个以上处理器缓存的内存区域数据,当其他处理器回写已被锁定的缓存行的数据时,会使缓存行无效。当CPU1修改缓存行中的i时使用了缓存锁定,那么CPU2不能同时缓存i的缓存行
    3. 两种情况不会使用缓存锁定
      1. 当操作的数据不能被缓存在处理器内部,或操作的数据跨多个缓存行时,则处理器会调用总线锁定
      2. 有些处理器不支持缓存锁定
  3. Java实现原子操作的方式:锁和循环CAS
    1. jvm中的CAS操作正是利用了处理器提供的CMPXCHG指令实现的。自旋CAS实现的基本思路就是循环进行CAS操作直接成功为止
    2. 锁机制保证了只有获得锁的线程才能够操作锁定的内存区域。jvm内部实现了很多种锁,有偏向锁、轻量级锁和互斥锁。除了偏向锁,jvm实现锁的方式都用了循环CAS,即当一个线程想进入同步块的时候使用循环CAS的方式来获取锁,当它退出同步块的时候使用循环CAS释放锁

Java内存模型(Java Memory Module,JMM)

Java内存模型基础
  1. 在并发编程中,需要处理两个问题:线程之间如何通信及线程之间如何同步。通信是指线程之间以何种机制来交换信息。在命令式编程中,线程之间的通信机制有两种:共享内存和信息传递
  2. 在共享内存的并发模型里,线程之间共享程序的公共状态,通过写—读内存中的公共状态进行隐式通信。在消息传递的并发模型里,线程之间没有公共状态,线程之间必须通过发送消息来显示进行通信
  3. 同步是指程序中用于控制不同线程间操作发生相对顺序的机制。在消息传递的并发模型里,由于消息的发送必须在消息的接受之前,因此同步是隐式进行的
Java内存结构的抽象结构
  1. 在Java中,所有实例域、静态域和数组元素都存储在堆内存中,堆内存在线程之间共享。局部变量(Local Variables),方法定义参数(Java语言规范称之为Formal Method Parameters)和异常处理器参数(ExceptionHandler Parameters)不会在线程之间共享,它们不会有内存可见性问题,也不受内存模型的影响

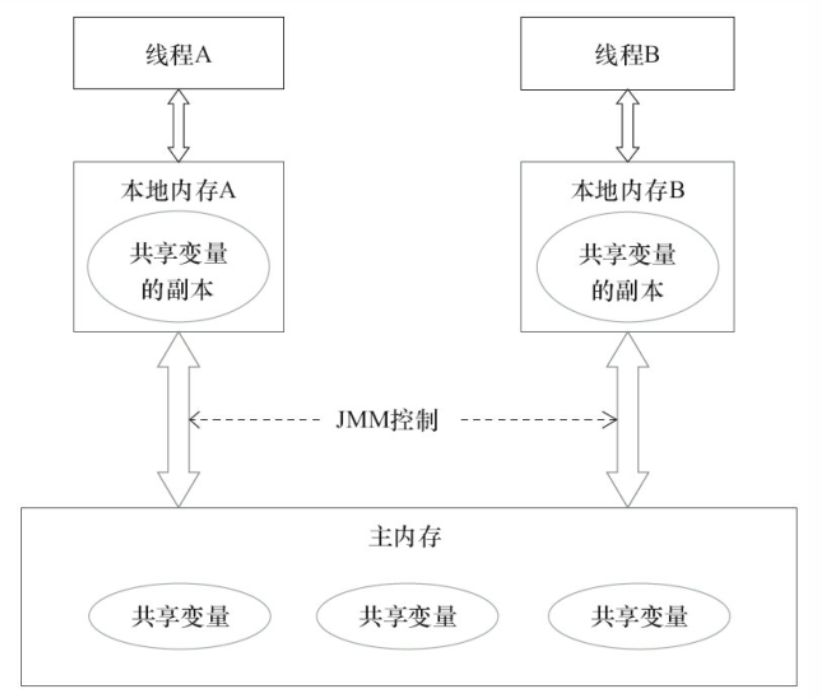
  2. Java线程之间的通信由Java内存模型控制,JMM决定一个线程对共享变量的写入何时对另一个线程可见。从抽象的角度来看,JMM定义了线程和主内存之间的抽象关系:线程之间的共享变量存储在主内存(Main Memory)中,每个线程都有一个私有的本地内存(Local Memory),本地内存中存储了该线程以读/写共享变量的副本。本地内存是JMM的一个抽象概念,并不真实存在。它涵盖了缓存、写缓冲区、寄存器以及其他的硬件和编译器优化

  1. 如果线程A与线程B之间要通信的话,必须要经历下面2个步骤。

    1. 线程A把本地内存A中更新过的共享变量刷新到主内存中去。
    2. 线程B到主内存中去读取线程A之前已更新过的共享变量

本地内存A和本地内存B由主内存中共享变量x的副本。假设初始时,这3个内存中的x值都为0。线程A在执行时,把更新后的x值(假设值为1)临时存放在自己的本地内存A中。当线程A和线程B需要通信时,线程A首先会把自己本地内存中修改后的x值刷新到主内存中,此时主内存中的x值变为了1。随后,线程B到主内存中去读取线程A更新后的x值,此时线程B的本地内存的x值也变为了1

从整体来看,这两个步骤实质上是线程A在向线程B发送消息,而且这个通信过程必须要经过主内存。JMM通过控制主内存与每个线程的本地内存之间的交互,来为Java程序员提供内存可见性保证

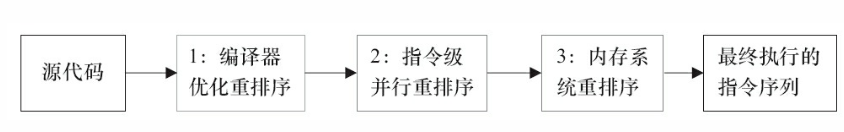
从源代码到指令序列的重排序

在执行程序时,为了提高性能,编译器和处理器常常会对指令做重排序。重排序分3种类型

  1. 编译器优化的重排序。编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序
  2. 指令级并行的重排序。现代处理器采用了指令级并行技术(Instruction-Level Parallelism,ILP)来将多条指令重叠执行。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序
  3. 内存系统的重排序。由于处理器使用缓存和读/写缓冲区,这使得加载和存储操作看上去可能是在乱序执行

上述的1属于编译器重排序,2和3属于处理器重排序。这些重排序可能会导致多线程程序出现内存可见性问题。对于编译器,JMM的编译器重排序规则会禁止特定类型的编译器重排序(不是所有的编译器重排序都要禁止)。对于处理器重排序,JMM的处理器重排序规则会要求Java编译器在生成指令序列时,插入特定类型的内存屏障(Memory Barriers,Intel称之为Memory Fence)指令,通过内存屏障指令来禁止特定类型的处理器重排序

JMM属于语言级的内存模型,它确保在不同的编译器和不同的处理器平台之上,通过禁 止特定类型的编译器重排序和处理器重排序,为程序员提供一致的内存可见性保证

并发编程模型分类
  1. 现代的处理器使用写缓冲区临时保存向内存写入的数据。写缓冲区可以保证指令流水线持续运行,它可以避免由于处理器停顿下来等待向内存写入数据而产生的延迟。同时,通过以批处理的方式刷新写缓冲区,以及合并写缓冲区中对同一内存地址的多次写,减少对内存总线的占用。虽然写缓冲区有这么多好处,但每个处理器上的写缓冲区,仅仅对它所在的处理器可见。这个特性会对内存操作的执行顺序产生重要的影响:处理器对内存的读/写操作的执行顺序,不一定与内存实际发生的读/写操作顺序一致!

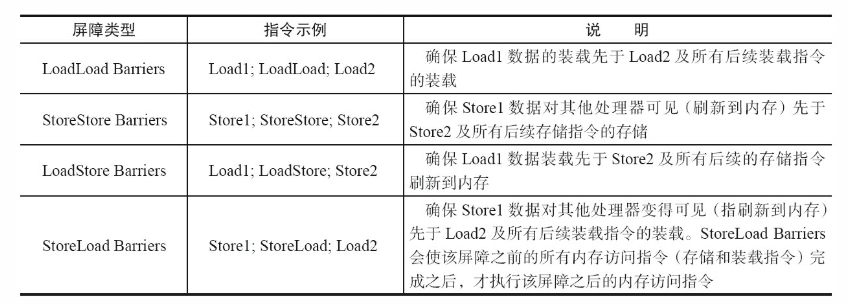
  2. 为了保证内存可见性,Java编译器在生成指令序列的适当位置会插入内存屏障指令来禁止特定类型的处理器重排序。JMM把内存屏障指令分为4类 :

  1. StoreLoad Barriers是一个"全能型"的屏障,它同时具有其他3个屏障的效果。现代的多处理器大多支持该屏障(其他类型的屏障不一定被所有处理器支持)。执行该屏障开销会很昂贵,因为当前处理器通常要把写缓冲区中的数据全部刷新到内存中(Buffer Fully Flush)。
happens-before
  1. 在JMM中,如果一个操作执行的结果需要对另一个操作可见,那么这两个操作之间必须要存在happens-before关系。这里提到的两个操作既可以是在一个线程之内,也可以是在不同线程之间
  2. happens-before原则如下:
    1. 程序顺序规则:一个线程中的每个操作,happens-before于该线程中的任意后续操作
    2. 监视器锁规则:对一个锁的解锁,happens-before于随后对这个锁的加锁
    3. volatile变量规则:对一个volatile域的写,happens-before于任意后续对这个volatile域的读
    4. 传递性:如果A happens-before B,且B happens-before C,那么A happens-before C。
重排序
  1. 重排序是指编译器和处理器为了优化程序性能而对指令序列进行重新排序的一种手段

  2. 如果两个操作访问同一个变量,且这两个操作中有一个为写操作,此时这两个操作之间就存在数据依赖性。存在数据依赖性的操作不能重排序

  3. as-if-serial语义

    1. as-if-serial语义的意思是:不管怎么重排序(编译器和处理器为了提高并行度),(单线程)程序的执行结果不能被改变。编译器、runtime和处理器都必须遵守as-if-serial语义。
    2. 为了遵守as-if-serial语义,编译器和处理器不会对存在数据依赖关系的操作做重排序,因为这种重排序会改变执行结果。但是,如果操作之间不存在数据依赖关系,这些操作就可能被编译器和处理器重排序
    3. as-if-serial语义把单线程程序保护了起来,遵守as-if-serial语义的编译器、runtime和处理器共同为编写单线程程序的程序员创建了一个幻觉:单线程程序是按程序的顺序来执行的。asif-serial语义使单线程程序员无需担心重排序会干扰他们,也无需担心内存可见性问题
    4. 在计算机中,软件技术和硬件技术有一个共同的目标:在不改变程序执行结果的前提下,尽可能提高并行度
    5. 在单线程程序中,对存在控制依赖的操作重排序,不会改变执行结果(这也是as-if-serial语义允许对存在控制依赖的操作做重排序的原因);但在多线程程序中,对存在控制依赖的操作重排序,可能会改变程序的执行结果
  4. 顺序一致性

    1. 顺序一致性内存模型是一个理论参考模型,在设计的时候,处理器的内存模型和编程语言的内存模型都会以顺序一致性内存模型作为参照

    2. 如果程序是正确同步的,程序的执行将具有顺序一致性(Sequentially Consistent)——即程序的执行结果与该程序在顺序一致性内存模型中的执行结果相同

    3. 顺序一致性内存模型有两大特性 :

      1. 一个线程中的所有操作必须按照程序的顺序来执行

      2. (不管程序是否同步)所有线程都只能看到一个单一的操作执行顺序。在顺序一致性内存模型中,每个操作都必须原子执行且立刻对所有线程可见

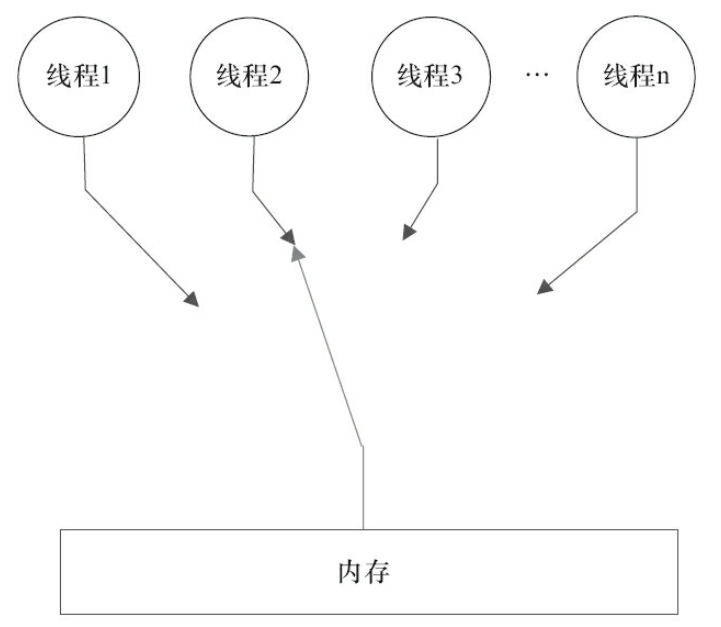
      3. 在概念上,顺序一致性模型有一个单一的全局内存,这个内存通过一个左右摆动的开关可以连接到任意一个线程,同时每一个线程必须按照程序的顺序来执行内存读/写操作。从上
        面的示意图可以看出,在任意时间点最多只能有一个线程可以连接到内存。当多个线程并发执行时,图中的开关装置能把所有线程的所有内存读/写操作串行化(即在顺序一致性模型中,所有操作之间具有全序关系)

      4. 对于未同步或未正确同步的多线程程序,JMM只提供最小安全性:线程执行时读取到的值,要么是之前某个线程写入的值,要么是默认值(0,Null,False),JMM保证线程读操作读取到的值不会无中生有(Out Of Thin Air)的冒出来。为了实现最小安全性,JVM在堆上分配对象时,首先会对内存空间进行清零,然后才会在上面分配对象(JVM内部会同步这两个操作)。因此,在已清零的内存空间(Pre-zeroed Memory)分配对象时,域的默认初始化已经完成了

      5. 在计算机中,数据通过总线在处理器和内存之间传递。每次处理器和内存之间的数据传递都是通过一系列步骤来完成的,这一系列步骤称之为总线事务(Bus Transaction)。总线事务包括读事务(Read Transaction)和写事务(Write
        Transaction)。读事务从内存传送数据到处理器,写事务从处理器传送数据到内存,每个事务会读/写内存中一个或多个物理上连续的字。这里的关键是,总线会同步试图并发使用总线的事务。在一个处理器执行总线事务期间,总线会禁止其他的处理器和I/O设备执行内存的读/写

volatile的内存语义
  1. 锁的happens-before规则保证释放锁和获取锁的两个线程之间的内存可见性,这意味着对一个volatile变量的读,总是能看到(任意线程)对这个volatile变量最后的写入
  2. volatile变量自身具有下列特性:
    1. 可见性:对一个volatile变量的读,总是能看到(任意线程)对这个volatile变量最后的写入
    2. 原子性:对任意单个volatile变量的读/写具有原子性,但类似于volatile++这种复合操作不具有原子性
  3. 从内存语义的角度来说,volatile的写-读与锁的释放-获取有相同的内存效果:volatile写和锁的释放有相同的内存语义;volatile读与锁的获取有相同的内存语义
  4. volatile写的内存语义:当写一个volatile变量时,JMM会把该线程对应的本地内存中的共享变量值刷新到主内存
  5. volatile读的内存语义:当读一个volatile变量时,JMM会把该线程对应的本地内存置为无效。线程接下来将从主内存中读取共享变量
  6. 如果我们把volatile写和volatile读两个步骤综合起来看的话,在读线程B读一个volatile变量后,写线程A在写这个volatile变量之前所有可见的共享变量的值都将立即变得对读线程B可见
  7. 对volatile写和volatile读的内存语义做个总结:
    1. 线程A写一个volatile变量,实质上是线程A向接下来将要读这个volatile变量的某个线程发出了(其对共享变量所做修改的)消息。
    2. 线程B读一个volatile变量,实质上是线程B接收了之前某个线程发出的(在写这个volatile变量之前对共享变量所做修改的)消息。
    3. 线程A写一个volatile变量,随后线程B读这个volatile变量,这个过程实质上是线程A通过主内存向线程B发送消息
  8. 为了实现volatile内存语义,JMM会分别限制这两种类型的重排序类型
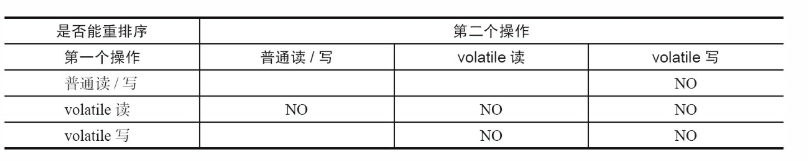
    1. 由表得出:

      1. 当第二个操作是volatile写时,不管第一个操作是什么,都不能重排序。这个规则确保volatile写之前的操作不会被编译器重排序到volatile写之后。
      2. 当第一个操作是volatile读时,不管第二个操作是什么,都不能重排序。这个规则确保volatile读之后的操作不会被编译器重排序到volatile读之前。
      3. 当第一个操作是volatile写,第二个操作是volatile读时,不能重排序
  9. 为了实现volatile的内存语义,编译器在生成字节码时,会在指令序列中插入内存屏障来禁止特定类型的处理器重排序。对于编译器来说,发现一个最优布置来最小化插入屏障的总数几乎不可能。为此,JMM采取保守策略。下面是基于保守策略的JMM内存屏障插入策略:
    1. 在每个volatile写操作的前面插入一个StoreStore屏障
    2. 在每个volatile写操作的后面插入一个StoreLoad屏障
    3. 在每个volatile读操作的后面插入一个LoadLoad屏障
    4. 在每个volatile读操作的后面插入一个LoadStore屏障
锁的内存语义
  1. 锁是Java并发编程中最重要的同步机制。锁除了让临界区互斥执行外,还可以让释放锁的线程向获取同一个锁的线程发送消息

  2. 锁的释放和获取的内存语义

    1. 当线程释放锁时,JMM会把该线程对应的本地内存中的共享变量刷新到主内存中
    2. 当线程获取锁时,JMM会把该线程对应的本地内存置为无效
  3. 对锁释放和锁获取的内存语义做个总结:

    1. 线程A释放一个锁,实质上是线程A向接下来将要获取这个锁的某个线程发出了(线程A对共享变量所做修改的)消息
    2. 线程B获取一个锁,实质上是线程B接收了之前某个线程发出的(在释放这个锁之前对共享变量所做修改的)消息
    3. 线程A释放锁,随后线程B获取这个锁,这个过程实质上是线程A通过主内存向线程B发送消息
  4. 锁内存语义的实现

    1. 利用volatile变量的写-读所具有的内存语义
    2. 利用CAS所附带的volatile读和volatile写的内存语义
final域的内存语义
  1. 对于final域,编译器和处理器要遵守两个重排序规则:

    1. 在构造函数内对一个final域的写入,与随后把这个被构造对象的引用赋值给一个引用变量,这两个操作之间不能重排序
    2. 初次读一个包含final域的对象的引用,与随后初次读这个final域,这两个操作之间不能重排序
  2. 写final域的重排序规则

    1. 写final域的重排序规则禁止把final域的写重排序到构造函数之外
      1. JMM禁止编译器把final域的写重排序到构造函数之外
      2. 编译器会在final域的写之后,构造函数return之前,插入一个StoreStore屏障。这个屏障禁止处理器把final域的写重排序到构造函数之外
      3. 简单的来说就是构造函数可以分批次初始化,final域要最先初始化
    2. 写final域的重排序规则可以确保:在对象引用为任意线程可见之前,对象的final域已经被正确初始化过了,而普通域不具有这个保障
  3. 读final域的重排序规则

    1. 读final域的重排序规则是,在一个线程中,初次读对象引用与初次读该对象包含的final域,JMM禁止处理器重排序这两个操作(注意,这个规则仅仅针对处理器)。编译器会在读final域操作的前面插入一个LoadLoad屏障
    2. 初次读对象引用与初次读该对象包含的final域,这两个操作之间存在间接依赖关系。由于编译器遵守间接依赖关系,因此编译器不会重排序这两个操作。大多数处理器也会遵守间接依赖,也不会重排序这两个操作。但有少数处理器允许对存在间接依赖关系的操作做重排序(比如alpha处理器),这个规则就是专门用来针对这种处理器的
    3. 读final域的重排序规则可以确保:在读一个对象的final域之前,一定会先读包含这个final域的对象的引用
  4. 当final域为引用类型,写final域的重排序规则对编译器和处理器增加了如下约束:在构造函数内对一个final引用的对象的成员域的写入,与随后在构造函数外把这个被构造对象的引用赋值给一个引用变量,这两个操作之间不能重排序

  5. happens-before

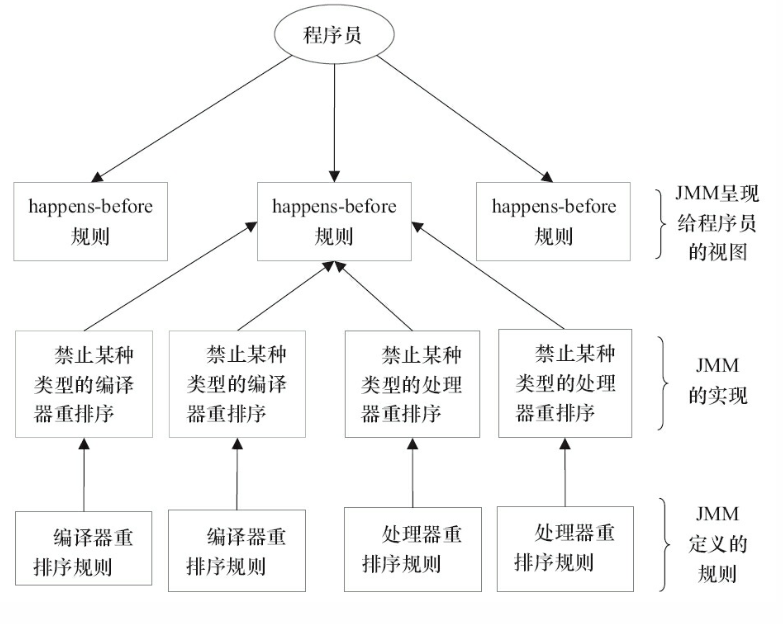
    1. 首先,让我们来看JMM的设计意图。从JMM设计者的角度,在设计JMM时,需要考虑两个关键因素:
      1. 程序员对内存模型的使用。程序员希望内存模型易于理解、易于编程。程序员希望基于一个强内存模型来编写代码
      2. 编译器和处理器对内存模型的实现。编译器和处理器希望内存模型对它们的束缚越少越好,这样它们就可以做尽可能多的优化来提高性能。编译器和处理器希望实现一个弱内存模型
    2. 由于这两个因素互相矛盾,所以JSR-133专家组在设计JMM时的核心目标就是找到一个好的平衡点:一方面,要为程序员提供足够强的内存可见性保证;另一方面,对编译器和处理。因此,JMM把happens-before要求禁止的重排序分为了下面两类。 器的限制要尽可能地放松:
      1. 会改变程序执行结果的重排序
      2. 不会改变程序执行结果的重排序
    3. JMM对这两种不同性质的重排序,采取了不同的策略:
      1. 对于会改变程序执行结果的重排序,JMM要求编译器和处理器必须禁止这种重排序
      2. 对于不会改变程序执行结果的重排序,JMM对编译器和处理器不做要求(JMM允许这种重排序)
    4. 只要不改变程序的执行结果(指的是单线程程序和正确同步的多线程程序),编译器和处理器怎么优化都行。例如,如果编译器经过细致的分析后,认定一个锁只会被单个线程访问,那么这个锁可以被消除。再如,如果编译器经过细致的分析后,认定一个volatile变量只会被单个线程访问,那么编译器可以把这个volatile变量当作一个普通变量来对待。这些优化既不会改变程序的执行结果,又能提高程序的执行效率
    5. happens-before关系本质上和as-if-serial语义是一回事,都是为了在不改变程序执行结果的前提下,尽可能地提高程序执行的并行度 :
      1. as-if-serial语义保证单线程内程序的执行结果不被改变,happens-before关系保证正确同步的多线程程序的执行结果不被改变
      2. as-if-serial语义给编写单线程程序的程序员创造了一个幻境:单线程程序是按程序的顺序来执行的。happens-before关系给编写正确同步的多线程程序的程序员创造了一个幻境:正确同步的多线程程序是按happens-before指定的顺序来执行的
  6. 双重检查锁定与延迟初始化

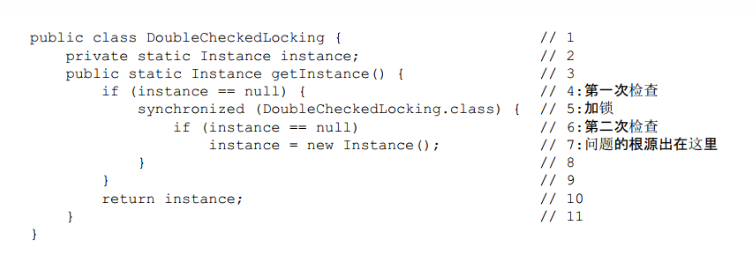
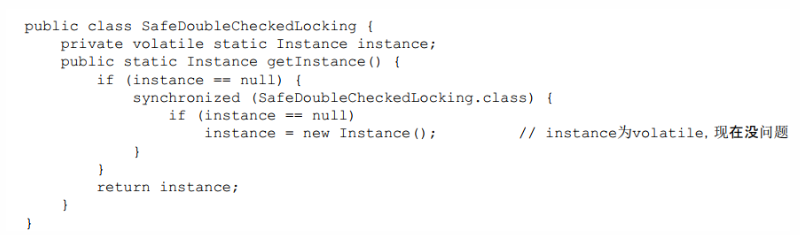
    1. 在早期的JVM中,synchronized(甚至是无竞争的synchronized)存在巨大的性能开销。因此,人们想出了一个"聪明"的技巧:双重检查锁定(Double-Checked Locking)。人们想通过双重检查锁定来降低同步的开销。下面是使用双重检查锁定来实现延迟初始化的示例代码

      在线程执行到第4行,代码读取到instance不为null时,instance引用的对象有可能还没有完成初始化

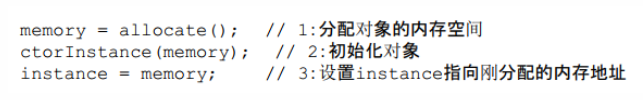
    2. 前面的双重检查锁定示例代码的第7行(instance=new Singleton();)创建了一个对象。这一行代码可以分解为如下的3行伪代码。

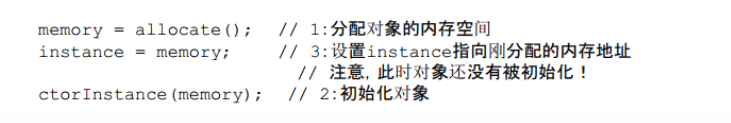
      上面3行伪代码中的2和3之间,可能会被重排序

      DoubleCheckedLocking示例代码的第7行(instance=new Singleton();)如果发生重排序,另一个并发执行的线程B就有可能在第4行判断instance不为null。线程B接下来将访问instance所引用的对象,但此时这个对象可能还没有被A线程初始化

    3. 在知晓了问题发生的根源之后,我们可以想出两个办法来实现线程安全的延迟初始化:

      1. 不允许2和3重排序 (volatile)
      2. 允许2和3重排序,但不允许其他线程"看到"这个重排序(静态内部类)
    4. 基于volatile解决办法

      代码中的2和3之间的重排序,在多线程环境中将会被禁止

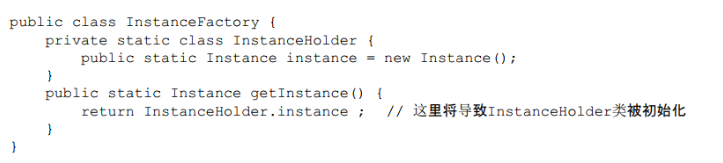
    5. 基于类初始化的解决方案

      1. JVM在类的初始化阶段(即在Class被加载后,且被线程使用之前),会执行类的初始化。在执行类的初始化期间,JVM会去获取一个锁。这个锁可以同步多个线程对同一个类的初始化

      2. 这个方案的实质是:允许上面中的3行伪代码中的2和3重排序,但不允许非构造线程(这里指线程B)"看到"这个重排序。

      3. 初始化一个类,包括执行这个类的静态初始化和初始化在这个类中声明的静态字段。根据Java语言规范,在首次发生下列任意一种情况时,一个类或接口类型T将被立即初始:

        1. T是一个类,而且一个T类型的实例被创建
        2. T是一个类,且T中声明的一个静态方法被调用
        3. T中声明的一个静态字段被赋值
        4. T中声明的一个静态字段被使用,而且这个字段不是一个常量字段
        5. T是一个顶级类,而且一个断言语句嵌套在T内部被执行
      4. Java语言规范规定,对于每一个类或接口C,都有一个唯一的初始化锁LC与之对应。从C到LC的映射,由JVM的具体实现去自由实现。JVM在类初始化期间会获取这个初始化锁,并且每个线程至少获取一次锁来确保这个类已经被初始化过了

    6. 通过对比基于volatile的双重检查锁定的方案和基于类初始化的方案,我们会发现基于类初始化的方案的实现代码更简洁。但基于volatile的双重检查锁定的方案有一个额外的优势:除了可以对静态字段实现延迟初始化外,还可以对实例字段实现延迟初始化

Java中的锁

Lock接口
  1. 锁是用来控制多个线程访问共享资源的方式,一般来说,一个锁能够防止多个线程同时访问共享资源(但是有些锁可以允许多个线程并发的访问共享资源,比如读写锁)。在Lock接口出现之前,Java程序是靠synchronized关键字实现锁功能的,而Java SE 5之后,并发包中新增了Lock接口(以及相关实现类)用来实现锁功能,它提供了与synchronized关键字类似的同步功
    能,只是在使用时需要显式地获取和释放锁。虽然它缺少了(通过synchronized块或者方法所提供的)隐式获取释放锁的便捷性,但是却拥有了锁获取与释放的可操作性、可中断的获取锁以及超时获取锁等多种synchronized关键字所不具备的同步特性
  2. 使用synchronized关键字将会隐式地获取锁,但是它将锁的获取和释放固化了,也就是先获取再释放。当然,这种方式简化了同步的管理,可是扩展性没有显示的锁获取和释放来的好。例如,针对一个场景,手把手进行锁获取和释放,先获得锁A,然后再获取锁B,当锁B获得后,释放锁A同时获取锁C,当锁C获得后,再释放B同时获取锁D,以此类推。这种场景下,synchronized关键字就不那么容易实现了,而使用Lock却容易许多
队列同步器
  1. 队列同步器AbstractQueuedSynchronizer(以下简称同步器),是用来构建锁或者其他同步组件的基础框架,它使用了一个int成员变量表示同步状态,通过内置的FIFO队列来完成资源获取线程的排队工作

  2. 同步器是实现锁(也可以是任意同步组件)的关键,在锁的实现中聚合同步器,利用同步器实现锁的语义。可以这样理解二者之间的关系:锁是面向使用者的,它定义了使用者与锁交互的接口(比如可以允许两个线程并行访问),隐藏了实现细节;同步器面向的是锁的实现者,它简化了锁的实现方式,屏蔽了同步状态管理、线程的排队、等待与唤醒等底层操作。锁和同步器很好地隔离了使用者和实现者所需关注的领域

  3. 同步器的设计是基于模板方法模式的,也就是说,使用者需要继承同步器并重写指定的方法,随后将同步器组合在自定义同步组件的实现中,并调用同步器提供的模板方法,而这些模板方法将会调用使用者重写的方法

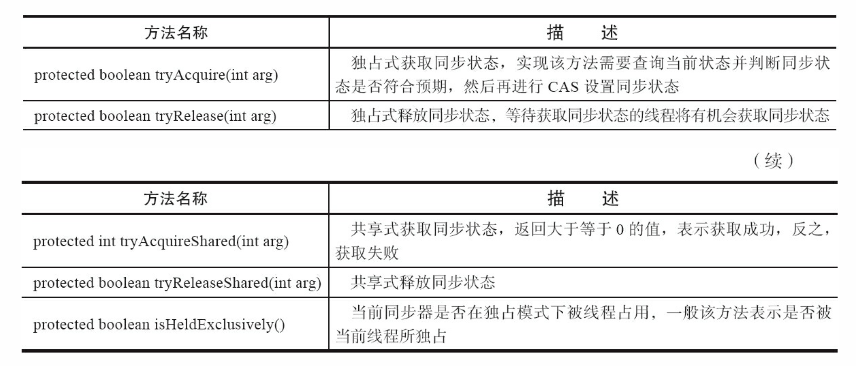
  4. 可重写的方法

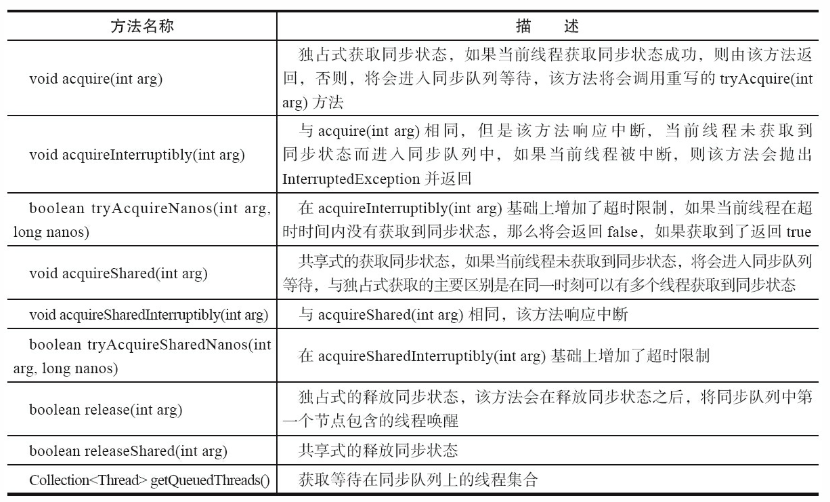
  1. 模板方法

  2. 同步器提供的模板方法基本上分为3类:独占式获取与释放同步状态、共享式获取与释放同步状态和查询同步队列中的等待线程情况。自定义同步组件将使用同步器提供的模板方法来实现自己的同步语义

  3. 自定义一个锁:继承实现Lock接口,使用静态内部类继承AbstractQueueSynchronizer,定义模板方法,重写相关的方法,使用模板方法模式以及代理模式,案例如下:

    class Mutex implements Lock {// 静态内部类,自定义同步器private static class Sync extends AbstractQueuedSynchronizer {// 是否处于占用状态protected boolean isHeldExclusively() {return getState() == 1;} // 当状态为0的时候获取锁public boolean tryAcquire(int acquires) {if (compareAndSetState(0, 1)) {setExclusiveOwnerThread(Thread.currentThread());return true;} return false;} // 释放锁,将状态设置为0protected boolean tryRelease(int releases) {if (getState() == 0) throw newIllegalMonitorStateException();setExclusiveOwnerThread(null);setState(0);return true;} // 返回一个Condition,每个condition都包含了一个condition队列Condition newCondition() { return new ConditionObject(); }} // 仅需要将操作代理到Sync上即可private final Sync sync = new Sync();public void lock() { sync.acquire(1); }public boolean tryLock() { return sync.tryAcquire(1); }public void unlock() { sync.release(1); }public Condition newCondition() { return sync.newCondition(); }public boolean isLocked() { return sync.isHeldExclusively(); }public boolean hasQueuedThreads() { return sync.hasQueuedThreads(); }public void lockInterruptibly() throws InterruptedException {sync.acquireInterruptibly(1);} public boolean tryLock(long timeout, TimeUnit unit) throws InterruptedException {return sync.tryAcquireNanos(1, unit.toNanos(timeout));}}
  4. 上述示例中,独占锁Mutex是一个自定义同步组件,它在同一时刻只允许一个线程占有锁。Mutex中定义了一个静态内部类,该内部类继承了同步器并实现了独占式获取和释放同步状态。在tryAcquire(int acquires)方法中,如果经过CAS设置成功(同步状态设置为1),则代表获取了同步状态,而在tryRelease(int releases)方法中只是将同步状态重置为0。用户使用Mutex时并不会直接和内部同步器的实现打交道,而是调用Mutex提供的方法,在Mutex的实现中,以获取锁的lock()方法为例,只需要在方法实现中调用同步器的模板方法acquire(int args)即可,当前线程调用该方法获取同步状态失败后会被加入到同步队列中等待,这样就大大降低了实现一个可靠自定义同步组件的门槛

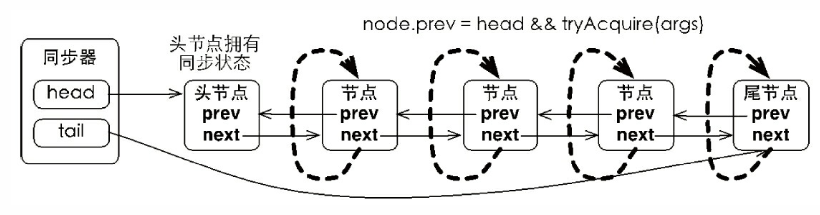
  5. 实现原理:单线程在获取同步状态(锁)时,如果未获取到,则会被创造成一个节点添加到同步队列的末尾,同步队列的所有节点都表示一个线程的引用,每个节点都在自旋,查看前一个结点是否是头节点,是的话就尝试获取同步状态,当成功获取后,会唤醒下一个节点,然后首节点去执行自己的任务,否则添加到队列末尾

重入锁
  1. 重入锁ReentrantLock,顾名思义,就是支持重进入的锁,它表示该锁能够支持一个线程对资源的重复加锁。除此之外,该锁的还支持获取锁时的公平和非公平性选择

  2. 重进入是指任意线程在获取到锁之后能够再次获取该锁而不会被锁所阻塞,该特性的实现需要解决以下两个问题

    1. 线程再次获取锁。锁需要去识别获取锁的线程是否为当前占据锁的线程,如果是,则再次成功获取
    2. 锁的最终释放。线程重复n次获取了锁,随后在第n次释放该锁后,其他线程能够获取到该锁。锁的最终释放要求锁对于获取进行计数自增,计数表示当前锁被重复获取的次数,而锁被释放时,计数自减,当计数等于0时表示锁已经成功释放
    3. 通过判断前线程是否为获取锁的线程来决定获取操作是否成功,如果是获取锁的线程再次求,则将同步状态值进行增加并返回true,表示获取同步状态成功
    4. 成功获取锁的线程再次获取锁,只是增加了同步状态值,这也就要求ReentrantLock在释放同步状态时减少同步状态值
  3. 公平锁与非公平锁

    公平性与否是针对获取锁而言的,如果一个锁是公平的,那么锁的获取顺序就应该符合请求的绝对时间顺序,也就是FIFO

读写锁
  1. 在基础部分已经介绍了相关的概念,这里说一些关于锁的设计的东西

  2. 读写锁同样依赖自定义同步器来实现同步功能,而读写状态就是其同步器的同步状态。回想ReentrantLock中自定义同步器的实现,同步状态表示锁被一个线程重复获取的次数,而读写锁的自定义同步器需要在同步状态(一个整型变量)上维护多个读线程和一个写线程的状态,使得该状态的设计成为读写锁实现的关键

  3. 如果在一个整型变量上维护多种状态,就一定需要"按位切割使用"这个变量,读写锁将变量切分成了两个部分,高16位表示读,低16位表示写

当前同步状态表示一个线程已经获取了写锁,且重进入了两次,同时也连续获取了两次读锁。读写锁是如何迅速确定读和写各自的状态呢? 答案是通过位运算。假设当前同步状态值为S,写状态等于S&0x0000FFFF(将高16位全部抹去),读状态等于S>>>16(无符号补0右移16位)。当写状态增加1时,等于S+1,当读状态增加1时,等于S+(1<<16),也就是S+0x00010000

根据状态的划分能得出一个推论:S不等于0时,当写状态(S&0x0000FFFF)等于0时,则读状态(S>>>16)大于0,即读锁已被获取

Condition接口
  1. 任意一个Jav对象,都拥有一组监视器方法(定义在java.lang.Object上),主要包括wait()、wait(long timeout)、notify()以及notifyAll()方法,这些方法与synchronized同步关键字配合,可以实现等待/通知模式。Condition接口也提供了类似Object的监视器方法,与Lock配合可以实现等待/通知模式,但是这两者在使用方式以及功能特性上还是有差别的

  2. Condition定义了等待/通知两种类型的方法,当前线程调用这些方法时,需要提前获取到Condition对象关联的锁。Condition对象是由Lock对象(调用Lock对象的newCondition()方法)创建出来的,换句话说,Condition是依赖Lock对象的

    Lock lock = new ReentrantLock();Condition condition = lock.newCondition();public void conditionWait() throws InterruptedException {lock.lock();try {condition.await();} finally {lock.unlock();}}public void conditionSignal() throws InterruptedException {lock.lock();try {condition.signal();} finally {lock.unlock();}}
    1. 等待队列

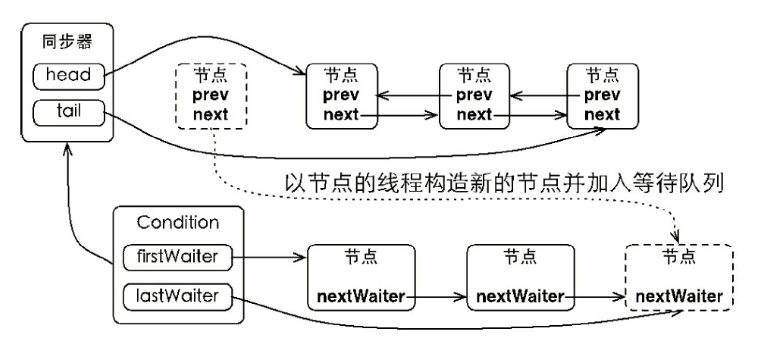
      1. 等待队列是一个FIFO的队列,在队列中的每个节点都包含了一个线程引用,该线程就是在Condition对象上等待的线程,如果一个线程调用了Condition.await()方法,那么该线程将会
        释放锁、构造成节点加入等待队列并进入等待状态。事实上,节点的定义复用了同步器中节点的定义,也就是说,同步队列和等待队列中节点类型都是同步器的静态内部类AbstractQueuedSynchronizer.Node

    2. 在Object的监视器模型上,一个对象拥有一个同步队列和等待队列,而并发包中的Lock(更确切地说是同步器)拥有一个同步队列和多个等待队列

    3. 等待

      1. 调用Condition的await()方法(或者以await开头的方法),会使当前线程进入等待队列并释放锁,同时线程状态变为等待状态。当从await()方法返回时,当前线程一定获取了Condition相关联的锁
      2. 如果从队列(同步队列和等待队列)的角度看await()方法,当调用await()方法时,相当于同步队列的首节点(获取了锁的节点)移动到Condition的等待队列中
      3. 调用该方法的线程成功获取了锁的线程,也就是同步队列中的首节点,该方法会将当前线程构造成节点并加入等待队列中,然后释放同步状态,唤醒同步队列中的后继节点,然后当前线程会进入等待状态
      4. 当等待队列中的节点被唤醒,则唤醒节点的线程开始尝试获取同步状态。如果不是通过其他线程调用Condition.signal()方法唤醒,而是对等待线程进行中断,则会抛出InterruptedException
    4. 通知

      1. 调用Condition的signal()方法,将会唤醒在等待队列中等待时间最长的节点(首节点),在唤醒节点之前,会将节点移到同步队列中

        public final void signal() {if (!isHeldExclusively())throw new IllegalMonitorStateException();Node first = firstWaiter;if (first != null)doSignal(first);}

        调用该方法的前置条件是当前线程必须获取了锁,可以看到signal()方法进行了isHeldExclusively()检查,也就是当前线程必须是获取了锁的线程。接着获取等待队列的首节点,将其移动到同步队列并使用LockSupport唤醒节点中的线程

​

Java并发容器和框架

ConcurrentHashMap的实现原理与使用
  1. 为什么要使用ConcurrentHashMap

    1. HashMap在并发执行put操作时会引起死循环,是因为多线程会导致HashMap的Entry链表形成环形数据结构,一旦形成环形数据结构,Entry的next节点永远不为空,就会产生死循环获
      取Entry
    2. HashMap在并发执行put操作时会引起死循环,是因为多线程会导致HashMap的Entry链表形成环形数据结构,一旦形成环形数据结构,Entry的next节点永远不为空,就会产生死循环获取Entry
    3. HashTable容器在竞争激烈的并发环境下表现出效率低下的原因是所有访问HashTable的线程都必须竞争同一把锁,假如容器里有多把锁,每一把锁用于锁容器其中一部分数据,那么当多线程访问容器里不同数据段的数据时,线程间就不会存在锁竞争,从而可以有效提高并发访问效率,这就是ConcurrentHashMap所使用的锁分段技术。首先将数据分成一段一段地存储,然后给每一段数据配一把锁,当一个线程占用锁访问其中一个段数据的时候,其他段的数据也能被其他线程访问
  2. ConcurrentHashMap的结构

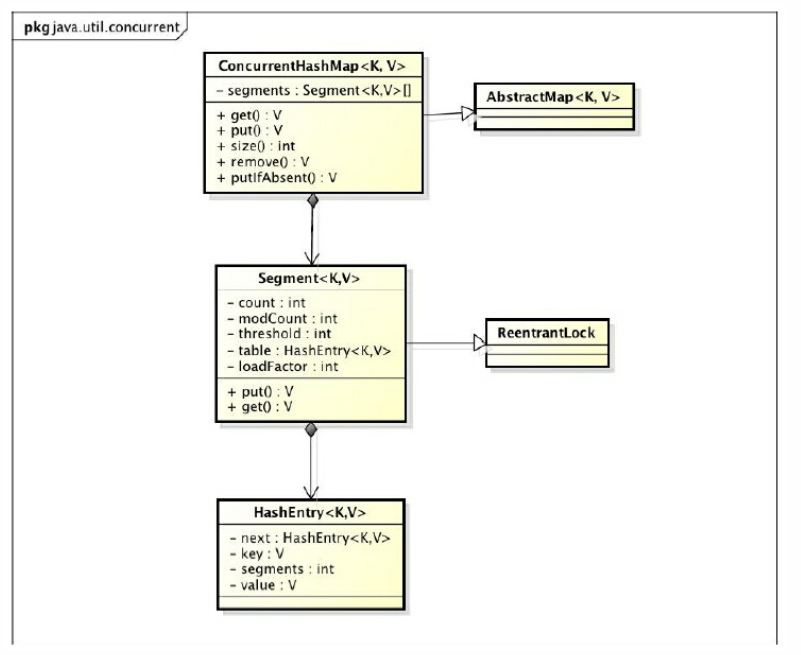
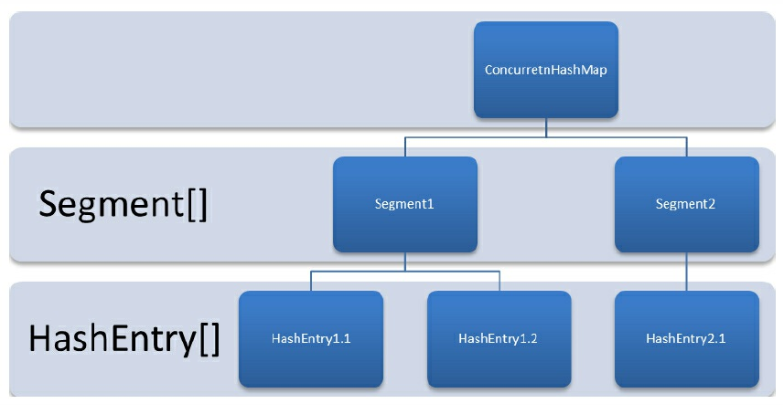
    1. ConcurrentHashMap是由Segment数组结构和HashEntry数组结构组成。Segment是一种可重入锁(ReentrantLock),在ConcurrentHashMap里扮演锁的角色;HashEntry则用于存储键值对数据。一个ConcurrentHashMap里包含一个Segment数组。Segment的结构和HashMap类似,是一种数组和链表结构。一个Segment里包含一个HashEntry数组,每个HashEntry是一个链表结构的元素,每个Segment守护着一个HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得与它对应的Segment锁

    2. ConcurrentHashMap的初始化

      ConcurrentHashMap初始化方法是通过initialCapacity、loadFactor和concurrencyLevel等几个参数来初始化segment数组、段偏移量segmentShift、段掩码segmentMask和每个segment里的HashEntry数组来实现的

    3. 定位Segment

      既然ConcurrentHashMap使用分段锁Segment来保护不同段的数据,那么在插入和获取元素的时候,必须先通过散列算法定位到Segment。可以看到ConcurrentHashMap会首先使用Wang/Jenkins hash的变种算法对元素的hashCode进行一次再散列。

    4. ConcurrentHashMap的操作

      1. get操作

        1. Segment的get操作实现非常简单和高效。先经过一次再散列,然后使用这个散列值通过散列运算定位到Segment,再通过散列算法定位到元素
        2. get操作的高效之处在于整个get过程不需要加锁,除非读到的值是空才会加锁重读。我们知道HashTable容器的get方法是需要加锁的,那么ConcurrentHashMap的get操作是如何做到不加锁的呢? 原因是它的get方法里将要使用的共享变量都定义成volatile类型,如用于统计当前Segement大小的count字段和用于存储值的HashEntry的value。定义成volatile的变量,能够在线程之间保持可见性,能够被多线程同时读,并且保证不会读到过期的值,但是只能被单线程写(有一种情况可以被多线程写,就是写入的值不依赖于原值),在get操作里只需要读不需要写共享变量count和value,所以可以不用加锁。之所以不会读到过期的值,是因为根据Java内存模型的happen before原则,对volatile字段的写入操作先于读操作,即使两个线程同时修改和获取volatile变量,get操作也能拿到最新的值,这是用volatile替换锁的经典应用场景
      2. put操作

        1. 由于put方法里需要对共享变量进行写入操作,所以为了线程安全,在操作共享变量时必须加锁。put方法首先定位到Segment,然后在Segment里进行插入操作。插入操作需要经历两个步骤,第一步判断是否需要对Segment里的HashEntry数组进行扩容,第二步定位添加元素的位置,然后将其放在HashEntry数组
          1. 在插入元素前会先判断Segment里的HashEntry数组是否超过容量(threshold),如果超过阈值,则对数组进行扩容。值得一提的是,Segment的扩容判断比HashMap更恰当,因为HashMap是在插入元素后判断元素是否已经到达容量的,如果到达了就进行扩容,但是很有可能扩容之后没有新元素插入,这时HashMap就进行了一次无效的扩容
          2. 在扩容的时候,首先会创建一个容量是原来容量两倍的数组,然后将原数组里的元素进行再散列后插入到新的数组里。为了高效,ConcurrentHashMap不会对整个容器进行扩容,而只对某个segment进行扩容
      3. size操作

        1. 如果要统计整个ConcurrentHashMap里元素的大小,就必须统计所有Segment里元素的大小后求和。Segment里的全局变量count是一个volatile变量,那么在多线程场景下,是不是直接把所有Segment的count相加就可以得到整个ConcurrentHashMap大小了呢? 不是的,虽然相加时可以获取每个Segment的count的最新值,但是可能累加前使用的count发生了变化,那么统计结果就不准了。所以,最安全的做法是在统计size的时候把所有Segment的put、remove和clean方法全部锁住,但是这种做法显然非常低效

          因为在累加count操作过程中,之前累加过的count发生变化的几率非常小,所以ConcurrentHashMap的做法是先尝试2次通过不锁住Segment的方式来统计各个Segment大小,如果统计的过程中,容器的count发生了变化,则再采用加锁的方式来统计所有Segment的大小

          那么ConcurrentHashMap是如何判断在统计的时候容器是否发生了变化呢? 使用modCount变量,在put、remove和clean方法里操作元素前都会将变量modCount进行加1,那么在统计size前后比较modCount是否发生变化,从而得知容器的大小是否发生变化

ConcurrentLinkedQueue

在并发编程中,有时候需要使用线程安全的队列。如果要实现一个线程安全的队列有两种方式:一种是使用阻塞算法,另一种是使用非阻塞算法。使用阻塞算法的队列可以用一个锁(入队和出队用同一把锁)或两个锁(入队和出队用不同的锁)等方式来实现。非阻塞的实现方式则可以使用循环CAS的方式来实现。本节让我们一起来研究一下Doug Lea是如何使用非阻塞的方式来实现线程安全队列ConcurrentLinkedQueue的,相信从大师身上我们能学到不少并发编程的技巧

ConcurrentLinkedQueue是一个基于链接节点的无界线程安全队列,它采用先进先出的规则对节点进行排序,当我们添加一个元素的时候,它会添加到队列的尾部;当我们获取一个元素时,它会返回队列头部的元素。它采用了"wait-free"算法(即CAS算法)来实现,该算法在Michael&Scott算法上进行了一些修改

阻塞队列
  1. 阻塞队列(BlockingQueue)是一个支持两个附加操作的队列。这两个附加的操作支持阻塞的插入和移除方法

    1. 支持阻塞的插入方法:意思是当队列满时,队列会阻塞插入元素的线程,直到队列不满
    2. 支持阻塞的移除方法:意思是在队列为空时,获取元素的线程会等待队列变为非空
  2. 阻塞队列常用于生产者和消费者的场景,生产者是向队列里添加元素的线程,消费者是从队列里取元素的线程。阻塞队列就是生产者用来存放元素、消费者用来获取元素的容器

  3. Java里的阻塞队列

    1. ArrayBlockingQueue:一个由数组结构组成的有界阻塞队列
    2. LinkedBlockingQueue:一个由链表结构组成的有界阻塞队列
    3. PriorityBlockingQueue:一个支持优先级排序的无界阻塞队列
    4. DelayQueue:一个使用优先级队列实现的无界阻塞队列
    5. SynchronousQueue:一个不存储元素的阻塞队列
    6. LinkedTransferQueue:一个由链表结构组成的无界阻塞队列
    7. LinkedBlockingDeque:一个由链表结构组成的双向阻塞队列
  4. 阻塞队列的实现原理

    1. 使用通知模式实现。所谓通知模式,就是当生产者往满的队列里添加元素时会阻塞住生产者,当消费者消费了一个队列中的元素后,会通知生产者当前队列可用

      1. private final Condition notFull;private final Condition notEmpty;public ArrayBlockingQueue(int capacity, boolean fair) {// 省略其他代码notEmpty = lock.newCondition();notFull = lock.newCondition();}public void put(E e) throws InterruptedException {checkNotNull(e);final ReentrantLock lock = this.lock;lock.lockInterruptibly();try {while (count == items.length)notFull.await();insert(e);} finally {lock.unlock();}}public E take() throws InterruptedException {final ReentrantLock lock = this.lock;lock.lockInterruptibly();try {while (count == 0)notEmpty.await();return extract();} finally {lock.unlock();}}private void insert(E x) {items[putIndex] = x;putIndex = inc(putIndex);++count;notEmpty.signal();}
    2. 当往队列里插入一个元素时,如果队列不可用,那么阻塞生产者主要通过LockSupport.park(this)来实现

      public final void await() throws InterruptedException {if (Thread.interrupted())throw new InterruptedException();Node node = addConditionWaiter();int savedState = fullyRelease(node);int interruptMode = 0;while (!isOnSyncQueue(node)) {LockSupport.park(this);if ((interruptMode = checkInterruptWhileWaiting(node)) != 0)break;}if (acquireQueued(node, savedState) && interruptMode != THROW_IE)interruptMode = REINTERRUPT;if (node.nextWaiter != null) // clean up if cancelledunlinkCancelledWaiters();if (interruptMode != 0)reportInterruptAfterWait(interruptMode);}

Java中的常用原子操作类

原子更新基本类型类
  1. AtomicBoolean:原子更新布尔类型
  2. AtomicInteger:原子更新整型
  3. AtomicLong:原子更新长整型
原子更新数组
  1. AtomicIntegerArray:原子更新整型数组里的元素
  2. AtomicLongArray:原子更新长整型数组里的元素
  3. AtomicReferenceArray:原子更新引用类型数组里的元素
原子更新引用类型
  1. AtomicReference:原子更新引用类型
  2. AtomicReferenceFieldUpdater:原子更新引用类型里的字段
  3. AtomicMarkableReference:原子更新带有标记位的引用类型
原子更新字段类
  1. AtomicIntegerFieldUpdater:原子更新整型的字段的更新器
  2. AtomicLongFieldUpdater:原子更新长整型字段的更新器
  3. AtomicStampedReference:原子更新带有版本号的引用类型

Java中的并发工具类

等待多线程完成的CountDownLatch
  1. CountDownLatch允许一个或多个线程等待其他线程完成操作

  2. public class CountDownLatchTest {staticCountDownLatch c = new CountDownLatch(2);public static void main(String[] args) throws InterruptedException {new Thread(new Runnable() {@Overridepublic void run() {System.out.println(1);c.countDown();System.out.println(2);c.countDown();}}).start();c.await();System.out.println("3");}}
  3. CountDownLatch的构造函数接收一个int类型的参数作为计数器,如果你想等待N个点完成,这里就传入N。当我们调用CountDownLatch的countDown方法时,N就会减1,CountDownLatch的await方法会阻塞当前线程,直到N变成零。由于countDown方法可以用在任何地方,所以这里说的N个点,可以是N个线程,也可以是1个线程里的N个执行步骤。用在多个线程时,只需要把这个CountDownLatch的引用传递到线程里即可

  4. 注意:计数器必须大于等于0,只是等于0时候,计数器就是零,调用await方法时不会阻塞当前线程;若计数器大于线程数,那么就会一直等待,不会执行await()后的语句。CountDownLatch不可能重新初始化或者修改CountDownLatch对象的内部计数器的值。一个线程调用countDown方法happen-before,另外一个线程调用await方法

同步屏障CyclicBarrier
  1. CyclicBarrier的字面意思是可循环使用(Cyclic)的屏障(Barrier)。它要做的事情是,让一组线程到达一个屏障(也可以叫同步点)时被阻塞,直到最后一个线程到达屏障时,屏障才会开门,所有被屏障拦截的线程才会继续运行

  2. CyclicBarrier默认的构造方法是CyclicBarrier(int parties),其参数表示屏障拦截的线程数量,每个线程调用await方法告诉CyclicBarrier我已经到达了屏障,然后当前线程被阻塞

  3. CyclicBarrier还提供一个更高级的构造函数CyclicBarrier(int parties,Runnable barrierAction),用于在线程到达屏障时,优先执行barrierAction,方便处理更复杂的业务场景

  4. package java_Multi_thread_programming.module.code46;import java.util.concurrent.BrokenBarrierException;import java.util.concurrent.CyclicBarrier;public class Test3 { public static void main(String[] args) {  Thread[] threads = new Thread[10];  CyclicBarrier cyclicBarrier = new CyclicBarrier(10, new Runnable() {   @Override   public void run() {    System.out.println("开始执行:"+System.currentTimeMillis());   }  });  for (int i = 0; i < threads.length; i++) {   threads[i] = new Thread(new Runnable() {    @Override    public void run() {     try {      cyclicBarrier.await();      System.out.println("线程"+Thread.currentThread().getName()+"执行:"+ System.currentTimeMillis());     } catch (InterruptedException | BrokenBarrierException e) {      e.printStackTrace();     }    }   });   threads[i].start();  } }}
  5. 注意:当传入的线程数大于线程使用的数时,会一直等待,知道使用的线程数等于拦截的线程数

  6. CyclicBarrier和CountDownLatch的区别

    1. CountDownLatch的计数器只能使用一次,而CyclicBarrier的计数器可以使用reset()方法重置。所以CyclicBarrier能处理更为复杂的业务场景。例如,如果计算发生错误,可以重置计数器,并让线程重新执行一次
    2. CountDownLatch的计数器只能使用一次,而CyclicBarrier的计数器可以使用reset()方法重置。所以CyclicBarrier能处理更为复杂的业务场景。例如,如果计算发生错误,可以重置计数器,并让线程重新执行一次
    3. CountDownLatch是执行完指定数量的线程后执行await()后的语句(代替join)使用;CyclicBarrier是当要执行的线程数够了才执行每个线程中await()后面的语句
    4. CountDownLatch(需要最后执行的语句前面)主要使用await()方法的位置不同于CyclicBarrier(每个线程)
控制并发线程数的Semaphore
  1. Semaphore(信号量)是用来控制同时访问特定资源的线程数量,它通过协调各个线程,以保证合理的使用公共资源。它比作是控制流量的红绿灯。比如××马路要限制流量,只允许同时有一百辆车在这条路上行使,其他的都必须在路口等待,所以前一百辆车会看到绿灯,可以开进这条马路,后面的车会看到红灯,不能驶入××马路,但是如果前一百辆中有5辆车已经离开了××马路,那么后面就允许有5辆车驶入马路,这个例子里说的车就是线程,驶入马路就表示线程在执行,离开马路就表示线程执行完成,看见红灯就表示线程被阻塞,不能执行

  2. public class SemaphoreTest {private static final int THREAD_COUNT = 30;private static ExecutorServicethreadPool = Executors.newFixedThreadPool(THREAD_COUNT);private static Semaphore s = new Semaphore(10);public static void main(String[] args) {for (inti = 0; i< THREAD_COUNT; i++) {threadPool.execute(new Runnable() {@Overridepublic void run() {try {s.acquire();System.out.println("save data");s.release();} catch (InterruptedException e) {}}});}threadPool.shutdown();}}
线程间交换数据的Exchanger
  1. Exchanger(交换者)是一个用于线程间协作的工具类。Exchanger用于进行线程间的数据交换。它提供一个同步点,在这个同步点,两个线程可以交换彼此的数据。这两个线程通过exchange方法交换数据,如果第一个线程先执行exchange()方法,它会一直等待第二个线程也执行exchange方法,当两个线程都到达同步点时,这两个线程就可以交换数据,将本线程生产出来的数据传递给对方

  2. package java_Multi_thread_programming.module.code46;import java.util.concurrent.Exchanger;public class Test4 { public static Exchanger<String> exchanger = new Exchanger<>(); public static void main(String[] args) {  new Thread(new Runnable() {   @Override   public void run() {    String string = ""+Thread.currentThread().getName();    try {     System.out.println(string+exchanger.exchange(string));    } catch (InterruptedException e) {     e.printStackTrace();    }   }  }, "线程1").start();  new Thread(new Runnable() {   @Override   public void run() {    String string1 = "" + Thread.currentThread().getName();    try {     System.out.println(string1+exchanger.exchange(string1));    } catch (InterruptedException e) {     e.printStackTrace();    }   }  }, "线程2").start(); }}
  3. 注意:如果两个线程有一个没有执行exchange()方法,则会一直等待,如果担心有特殊情况发生,避免一直等待,可以使用exchange(V x,longtimeout,TimeUnit unit)设置最大等待时长

Java中的线程池

Java中的线程池是运用场景最多的并发框架,几乎所有需要异步或并发执行任务的程序都可以使用线程池。在开发过程中,合理地使用线程池能够带来3个好处
第一:降低资源消耗。通过重复利用已创建的线程降低线程创建和销毁造成的消耗
第二:提高响应速度。当任务到达时,任务可以不需要等到线程创建就能立即执行
第三:提高线程的可管理性。线程是稀缺资源,如果无限制地创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行统一分配、调优和监控

线程池的实现原理

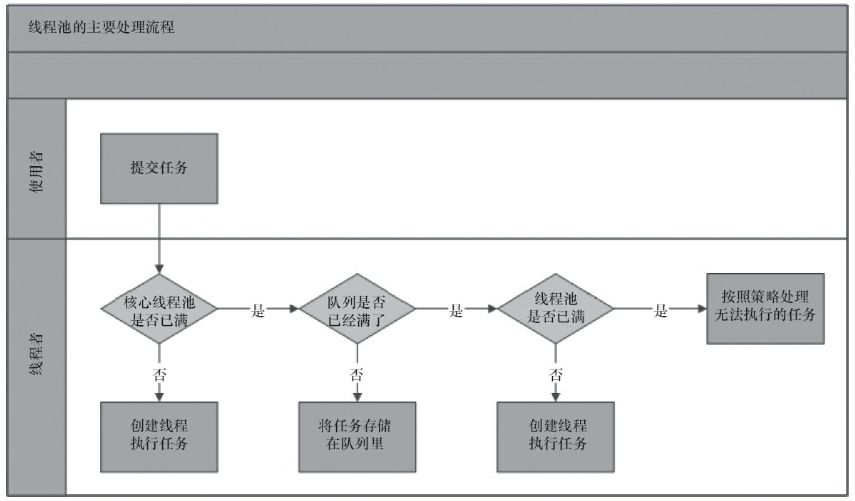
从图中可以看出,当提交一个新任务到线程池时,线程池的处理流程如下

  1. 线程池判断核心线程池里的线程是否都在执行任务。如果不是,则创建一个新的工作线程来执行任务。如果核心线程池里的线程都在执行任务,则进入下个流程
  2. 线程池判断工作队列是否已经满。如果工作队列没有满,则将新提交的任务存储在这个工作队列里。如果工作队列满了,则进入下个流程
  3. 线程池判断线程池的线程是否都处于工作状态。如果没有,则创建一个新的工作线程来执行任务。如果已经满了,则交给饱和策略来处理这个任务

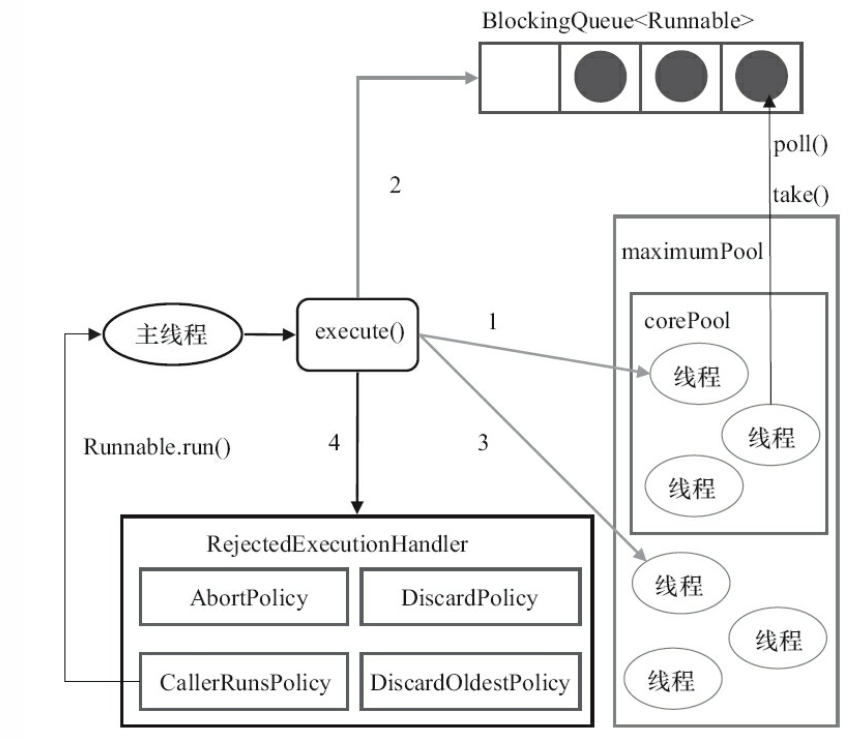
ThreadPoolExecutor执行execute()方法的示意图如下:

ThreadPoolExecutor执行execute方法分下面4种情况

  1. 如果当前运行的线程少于corePoolSize,则创建新线程来执行任务(注意,执行这一步骤需要获取全局锁)
  2. 如果运行的线程等于或多于corePoolSize,则将任务加入BlockingQueue
  3. 如果无法将任务加入BlockingQueue(队列已满),则创建新的线程来处理任务(注意,执行这一步骤需要获取全局锁)
  4. 如果创建新线程将使当前运行的线程超出maximumPoolSize,任务将被拒绝,并调用RejectedExecutionHandler.rejectedExecution()方法

ThreadPoolExecutor采取上述步骤的总体设计思路,是为了在执行execute()方法时,尽可能地避免获取全局锁(那将会是一个严重的可伸缩瓶颈)。在ThreadPoolExecutor完成预热之后(当前运行的线程数大于等于corePoolSize),几乎所有的execute()方法调用都是执行步骤2,而步骤2不需要获取全局锁

线程池中的线程执行任务分两种情况,如下

  1. 在execute()方法中创建一个线程时,会让这个线程执行当前任务
  2. 这个线程执行完上图中1的任务后,会反复从BlockingQueue获取任务来执行
线程池的使用
  1. 线程池的创建

    1. new ThreadPoolExecutor(corePoolSize, maximumPoolSize, keepAliveTime,milliseconds,runnableTaskQueue, handler);
    2. 创建一个线程池时需要输入几个参数,如下 :

      1. corePoolSize(线程池的基本大小):当提交一个任务到线程池时,线程池会创建一个线程来执行任务,即使其他空闲的基本线程能够执行新任务也会创建线程,等到需要执行的任
        务数大于线程池基本大小时就不再创建。如果调用了线程池的prestartAllCoreThreads()方法,线程池会提前创建并启动所有基本线程

      2. runnableTaskQueue(任务队列):用于保存等待执行的任务的阻塞队列。可以选择以下几个阻塞队列

        1. ArrayBlockingQueue:是一个基于数组结构的有界阻塞队列,此队列按FIFO(先进先出)原则对元素进行排序
        2. LinkedBlockingQueue:一个基于链表结构的阻塞队列,此队列按FIFO排序元素,吞吐量通常要高于ArrayBlockingQueue。静态工厂方法Executors.newFixedThreadPool()使用了这个队列
        3. SynchronousQueue:一个不存储元素的阻塞队列。每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于Linked-BlockingQueue,静态工厂方法Executors.newCachedThreadPool使用了这个队列
        4. PriorityBlockingQueue:一个具有优先级的无限阻塞队列
      3. maximumPoolSize(线程池最大数量):线程池允许创建的最大线程数。如果队列满了,并且已创建的线程数小于最大线程数,则线程池会再创建新的线程执行任务。值得注意的是,如果使用了无界的任务队列这个参数就没什么效果

      4. ThreadFactory:用于设置创建线程的工厂,可以通过线程工厂给每个创建出来的线程设置更有意义的名字。使用开源框架guava提供的ThreadFactoryBuilder可以快速给线程池里的线
        程设置有意义的名字,代码如下

        new ThreadFactoryBuilder().setNameFormat("XX-task-%d").build();
      5. RejectedExecutionHandler(饱和策略):当队列和线程池都满了,说明线程池处于饱和状态,那么必须采取一种策略处理提交的新任务。这个策略默认情况下是AbortPolicy,表示无法处理新任务时抛出异常。在JDK 1.5中Java线程池框架提供了以下4种策略

        1. AbortPolicy:直接抛出异常
        2. CallerRunsPolicy:只用调用者所在线程来运行任务
        3. DiscardOldestPolicy:丢弃队列里最近的一个任务,并执行当前任务
        4. DiscardPolicy:不处理,丢弃掉。当然,也可以根据应用场景需要来实现RejectedExecutionHandler接口自定义策略。如记录日志或持久化存储不能处理的任务
        5. keepAliveTime(线程活动保持时间):线程池的工作线程空闲后,保持存活的时间。所以,如果任务很多,并且每个任务执行的时间比较短,可以调大时间,提高线程的利用率
        6. TimeUnit(线程活动保持时间的单位):可选的单位有天(DAYS)、小时(HOURS)、分钟(MINUTES)、毫秒(MILLISECONDS)、微秒(MICROSECONDS,千分之一毫秒)和纳秒(NANOSECONDS,千分之一微秒)
  2. 向线程池提交任务

    1. 可以使用两个方法向线程池提交任务,分别为execute()和submit()方法
    2. execute()方法用于提交不需要返回值的任务,所以无法判断任务是否被线程池执行成功
    3. submit()方法用于提交需要返回值的任务。线程池会返回一个future类型的对象,通过这个future对象可以判断任务是否执行成功,并且可以通过future的get()方法来获取返回值,get()方法会阻塞当前线程直到任务完成,而使用get(long timeout,TimeUnit unit)方法则会阻塞当前线程一段时间后立即返回,这时候有可能任务没有执行完
  3. 关闭线程池

    1. 可以通过调用线程池的shutdown或shutdownNow方法来关闭线程池。它们的原理是遍历线程池中的工作线程,然后逐个调用线程的interrupt方法来中断线程,所以无法响应中断的任务可能永远无法终止。但是它们存在一定的区别,shutdownNow首先将线程池的状态设置成STOP,然后尝试停止所有的正在执行或暂停任务的线程,并返回等待执行任务的列表,而shutdown只是将线程池的状态设置成SHUTDOWN状态,然后中断所有没有正在执行任务的线程
    2. 只要调用了这两个关闭方法中的任意一个,isShutdown方法就会返回true。当所有的任务都已关闭后,才表示线程池关闭成功,这时调用isTerminaed方法会返回true。至于应该调用哪一种方法来关闭线程池,应该由提交到线程池的任务特性决定,通常调用shutdown方法来关闭线程池,如果任务不一定要执行完,则可以调用shutdownNow方法


原文转载:http://www.shaoqun.com/a/595575.html

跨境电商:https://www.ikjzd.com/

飞书互动:https://www.ikjzd.com/w/1319.html

costco:https://www.ikjzd.com/w/1680


关于Java高并发编程你需要知道的"升段攻略"基础Thread对象调用start()方法包含的步骤通过jvm告诉操作系统创建Thread操作系统开辟内存并使用WindowsSDK中的createThread()函数创建Thread线程对象操作系统对Thread对象进行调度,以确定执行时机Thread在操作系统中被成功执行执行start的顺序不代表执行run的顺序执行方法run和start有区别xx
急速:https://www.ikjzd.com/w/1861
沃尔玛:https://www.ikjzd.com/w/220
网络星期一:https://www.ikjzd.com/w/80
旺季侵权频发,亚马逊运营七大要点避开雷区!:https://www.ikjzd.com/home/108431
超1500万奢侈品消费者,eBay欲招揽更多奢侈品牌商入驻:https://www.ikjzd.com/home/1908
pat:https://www.ikjzd.com/w/1079

东契奇恭维哈登单核带队 纳什:不能只靠胡子一人_比赛

原标题:东契奇恭维哈登单核带队 纳什:不能只靠胡子一人

北京时间2月28日,2020-21赛季NBA常规赛继续进行,布鲁克林篮网主场迎战达拉斯独行侠。全场打完,篮网98-115不敌独行侠,八连胜终结。

此役,东契奇入账27分7助攻6篮板的全面数据,他从首节就为独行侠确立了赢球基调,并带队取得一场大胜。

赛后,谈到这场胜利,东契奇谦虚依旧,他表示,"我们今天打得更像个整体,你知道,对手是一支很出色的球队,虽然他们缺少了两名球星,但这场比赛依旧很难打,好在我们全队努力赢了下来。"

东契奇也谈到了有关将他和拉里-伯德相比较的言论,"我看过他的很多比赛录像,但我还没法与他相提并论……我还有很长的路要走,你们不能把我与他类比……我还是要好好打球,享受比赛。"

东契奇还赞扬了波尔津吉斯的发挥,他表示,"波津之前遭遇背伤,但今天,我感觉他打得很舒服,一有换防我们就找他打低位,让他进入了舒适的状态。"

赛后,哈登坦言,"我们没有状态,在下半场比赛中,我们都精疲力尽了,我们得打得更好一些……虽然欧文缺阵,但我并没有试图比平时做更多,有时候我们难免会打出不好的比赛。"

哈登还赞扬了东契奇,并表示,"独行侠得到了一名与众不同的球员。"

本场球,独行侠下半场对哈登严密盯防,让他只得到了4分,对此,主防哈登的芬尼-史密斯表示,"我每个回合都会遭遇他们的掩护阻挡,但是队里的每个球员及时的换防了上去,让哈登很难出手。"

对此,篮网主帅纳什就认为,"我们还有詹姆斯-哈登,他在场上能做许多事情……但我们不能只靠他一个人,我们全队都得打得更好,其他人也要在攻防两端站出来,这样才能击败独行侠这种强队。"(波洛)返回搜狐,查看更多

责任编辑:

原文转载:http://sport.shaoqun.com/a/457738.html

跨境电商:https://www.ikjzd.com/

6pm:https://www.ikjzd.com/w/317

马莎:https://www.ikjzd.com/w/2385


原标题:东契奇恭维哈登单核带队纳什:不能只靠胡子一人北京时间2月28日,2020-21赛季NBA常规赛继续进行,布鲁克林篮网主场迎战达拉斯独行侠。全场打完,篮网98-115不敌独行侠,八连胜终结。此役,东契奇入账27分7助攻6篮板的全面数据,他从首节就为独行侠确立了赢球基调,并带队取得一场大胜。赛后,谈到这场胜利,东契奇谦虚依旧,他表示,"我们今天打得更像个整体,你知道,对手是一支很出色的球队,虽
tm商标:https://www.ikjzd.com/w/1069
airwallex:https://www.ikjzd.com/w/1011
lithium:https://www.ikjzd.com/w/2505
(市场调查)eBay澳洲站休闲装类目市场调查数据报告:https://www.ikjzd.com/home/17618
纯干货分析:如何通过Shopify降低Amazon运营风险?:https://www.ikjzd.com/home/97568
口述:两年没上床 我该不该红杏出墙:http://lady.shaoqun.com/m/a/9284.html

2021年2月27日星期六

探索档案里面世界上比较少见的一些动物

在探索档案中记载着很多不一样的事件,而其中人们也会发现有着各种不一样的动物,其中比较常见的就是一种螃蟹,这种螃蟹和我们平时所吃的螃蟹有所区别,浑身都是剧毒,是绝世罕见的。现在这种螃蟹只有在日本才有机会发现,它的毒性很强,在食用之后马上就会死亡。

图片6.png 

    探索档案中,人们还会看到另外一种龙虾,这种龙虾有两种颜色,一半是黑色,一半是黄红色,至今为止都是一种非常独特的龙虾,目前已经生活在海洋馆内。


    再来看一下下面的这个动物,这是在我国四川的一个原始森林里面所看到,从外表来看和熊比较相似,但是他有一个如同袋鼠一样的尾巴,并且浑身上下没有任何的毛发,而且叫声比较像猫。这到底是一只什么样的动物,到目前为止动物专家也没有办法给出答案,即便进行DNA的鉴定也并不知晓,这到底是怎么回事?


    在许多的探索档案中都可以看到大象,但是可能人们并没有看到过如此罕见的白象,这头白象的年龄在18岁左右身高在2.16米,这也是缅甸最近10年来所发现的第5只大象,而它也有着非常独特的外观,浑身上下没有其他的颜色,全部都是白色的。要知道缅甸人一直以来都会非常盲目的崇拜白象,认为这就是帝王的象征,会把他像神一样供奉着。另外人们还会看到有一只紫色的松鼠,这如此罕见的颜色,也同样让人觉得有一些叹为观止。


原文转载:http://tech.shaoqun.com/a/357774.html

跨境电商:https://www.ikjzd.com/

环球市场:https://www.ikjzd.com/w/1762

vat:https://www.ikjzd.com/w/109


在探索档案中记载着很多不一样的事件,而其中人们也会发现有着各种不一样的动物,其中比较常见的就是一种螃蟹,这种螃蟹和我们平时所吃的螃蟹有所区别,浑身都是剧毒,是绝世罕见的。现在这种螃蟹只有在日本才有机会发现,它的毒性很强,在食用之后马上就会死亡。探索档案中,人们还会看到另外一种龙虾,这种龙虾有两种颜色,一半是黑色,一半是黄红色,至今为止都是一种非常独特的龙虾,目前已经生活在海洋馆内。再来看一下下面的
派代:https://www.ikjzd.com/w/2197
aicpa:https://www.ikjzd.com/w/1373
ryder:https://www.ikjzd.com/w/1264.html
品牌与买手加强对接 打破跨境购买渠道局限:https://www.ikjzd.com/home/17770
今年的Prime Day不如往年?巧了,买家们也这么觉得:https://www.ikjzd.com/home/101393
如何通过邮件营销获得亚马逊安全Review?:https://www.ikjzd.com/home/244